perplexity 產品不咋樣,但這個 Skills 文檔寫得是真的好!
整理版優先睇
Perplexity Skills文檔精髓:寫意圖而非步驟,反面案例比正面更值錢
呢篇文出自字節筆記嘅博主,佢分析咗Perplexity最近公開嘅一份內部Skills文檔。Perplexity嘅產品雖然一般,但呢份文檔寫得極好,顛覆咗好多人寫Skills嘅慣常做法。作者想解決嘅問題係:點樣寫Skills先至真正幫到模型,而唔係浪費上下文?整體結論係:寫Skills唔係寫說明書,而係寫你腦入面模型學唔到嘅判斷;描述要用用戶嘅口吻寫,反面案例比正面案例更有價值。
首先,文檔指出寫Skills最大嘅錯誤係當說明文來寫,以為列出命令、步驟、注意事項就得。但模型其實已經識曬呢啲嘢,寫咗等於浪費token,仲會稀釋真正有用嘅信息。正確做法係俾意圖,唔好俾步驟。例如處理代碼合併,唔好寫git指令,而係話「把呢個提交到一個乾淨嘅分支,解決衝突時保留原始意圖」。模型用後者表現好得多。另外,文檔將技能加載開銷分成三層:索引層(每個技能名+描述,約100 token)、正文層(理想5000 token內)、運行層(按需加載)。上下文有成本,所以技能一定要短,描述要精準。
其次,技能描述唔係說明書,而係路由觸發器。要以「當……時加載」開頭,目標50詞以內,用真實用戶會講嘅話寫。例如,唔好寫「監控代碼合併請求嘅狀態」,而係寫「當用戶想『盯住』一個合併請求落地、或者擔心流水線掛掉時加載」。模型靠呢啲關鍵詞匹配。文檔仲提到,有啲嘢模型學唔到,例如審美判斷,呢啲先係要寫入Skills嘅嘢。最後,技能維護應該「只增不改」,每次模型…
- 寫Skills嘅核心係寫意圖,而唔係寫步驟;模型已知嘅步驟唔需要重複,寫咗只係浪費上下文。
- 技能描述係路由觸發器,要以用戶嘅口吻寫,例如「當用戶想『盯住』一個合併請求時加載」,而唔係「監控合併請求狀態」。
- 上下文成本分三層:索引層、正文層、運行層;技能正文最好控制喺5000 token內,索引層每個約100 token。
- 反面案例比正面案例更有價值,維護策略係「只增不改」,每次出錯就加反面案例,唔好改描述或加新規則。
- 注入模型學唔到嘅經驗同判斷,例如設計師對字體嘅「感覺」,先係Skills嘅真正價值所在。
Perplexity內部Skills文檔原文
文章引用嘅Perplexity公開文檔,詳細講解Skills設計、迭代同維護原則。
作者Skills庫
作者分享嘅一堆Claude Code Skills,包括設計、開發等類別。
內容片段
git log          # 找到提交
git checkout main
git checkout -b <新分支>
git cherry-pick <提交>寫Skills嘅常見錯誤:當說明文咁寫
好多人寫Skills最根深蒂固嘅錯誤,就係當說明文檔來寫:列命令、列步驟、列注意事項。但呢啲嘢模型本身已經識曬,寫咗等於浪費上下文,仲會稀釋真正有價值嘅信息。Perplexity嘅文檔開頭就用一個類比點破咗:如果一件事很容易解釋,說明模型早就知道了。刪掉它。
如果一件事很容易解釋,說明模型早就知道了。刪掉它。
作者仲提到自己用Claude Code嘅體會:刻意提出模糊需求,等模型提供多種方案再選擇。咁樣先可以發揮模型本身嘅潛能,而唔係被自己嘅認知框死。
同臭棋簍子下棋越下越臭,你嘅認知高度會限制模型嘅上限。
上下文成本三層模型:每一層都在燒錢
Perplexity將技能嘅加載開銷分成三層,呢個分法比官方文檔清晰得多。第一層係索引層:每個技能嘅名稱加描述,無論用戶問咩,每次對話都要付呢個成本。預算係每個技能約100 token,能短則短。第二層係正文層:技能主體,理想控制喺5000 token以內。一旦加載就要扛到上下文壓縮。第三層係運行層:腳本、參考文檔、輸出模板呢啲附屬文件,只有模型真正需要時先讀取,冇上限。
上下文係有成本嘅,每一層都在燒錢。
文檔引用咗帕斯卡嘅名言:「我把呢封信寫得咁長,只係因為我冇時間將佢寫短。」短唔係懶,短係功夫。如果你寫一個技能好容易就寫好,好大可能係寫多咗,或者根本唔需要佢。
技能裏嘅廢話唔止浪費自己嘅空間,仲會壓縮其他技能嘅發揮餘地。
- 索引層:每個技能名+描述,約100 token,每次對話都要負擔
- 正文層:技能主體,理想5000 token內,一次對話通常加載3-5個技能
- 運行層:附屬文件,按需讀取,冇上限
技能描述:路由觸發器,唔係說明書
技能描述並唔係用嚟解釋技能做咩,而係用嚟觸發模型加載技能。Perplexity要求格式以「當……時加載」開頭,目標50詞以內,用真實用戶講嘢嘅方式寫。舉例:一個監控代碼合併請求嘅技能,差嘅寫法係「監控代碼合併請求嘅狀態」,好嘅寫法係「當用戶想『盯住』一個合併請求順利落地、或者擔心流水線掛掉時加載」。後者包含關鍵詞「盯住」「合併」「掛掉」,模型靠呢啲匹配。
模型真正匹配嘅係關鍵詞同關鍵詞密度,而唔係功能描述。
另外,有啲嘢模型學唔到,只能靠你寫。例如Perplexity嘅設計負責人Henry親自寫嘅字體技能,包含字體嘅「感覺」——呢個係審美判斷,唔係知識點。模型可以知道Helvetica係咩,但完全唔理解呢個字體喺某啲場景下會顯得好low。
真正的審美判斷來自經驗同品味,呢啲可以透過技能注入俾模型。
模型本身唔具備審美能力,所有「審美」都係依賴概率同使用者品味。
反面案例比正面案例更值錢
Perplexity嘅技能維護策略係「只增不改」,而且主要往反面案例區域追加內容。每次模型出錯,就加一條反面案例,而唔係修改描述或加新規則。反面案例直接話俾模型知呢條路行唔通,信息密度更高。
文檔仲提到一個重要副作用:加一個新技能可能會令已有技能變差。因為索引層嘅描述都在爭奪模型注意力,兩個描述相近嘅技能會互相干擾。所以每次新增技能都要跑一遍已有技能嘅測試,確認冇連帶破壞。
加一個新技能,可能會讓已有的技能變差。
最後,一句說話送俾仲將技能當說明文寫嘅人:如果模型冇呢個技能都能做對,咁就唔需要呢個技能。呢份文檔值得反覆讀,而且唔止侷限於寫Skills,可以應用喺同模型對話嘅方方面面。
如果模型冇呢個技能都能做對,咁就唔需要呢個技能。
Perplexity 最近公開咗一篇內部工程文檔,講佢哋點樣設計、迭代同維護 Agent Skills 庫。
原文網址如下:
https://link.bytenote.net/DapXMD
Perplexity 嘅產品做得麻麻地,但呢篇文檔講點樣寫 Skills 呢件事,就講得比任何人都要好。
文章裏面嘅結論幾乎每一個都違反常理,但如果細心咀嚼就會發現異常合理,值得我哋參考同實踐。
例如開頭引用類似 Python 之禪呢本書,講 Python 嘅設計哲學係「簡單優於複雜」、「明確優於隱式」,但係喺寫技能嘅時候就完全唔係咁回事。
「如果一件事好容易解釋,即係模型一早已經知道。刪咗佢。」
文檔一針見血。我哋寫技能時最大嘅本能錯誤,就係當佢係說明文檔咁寫。
乜都列曬命令、步驟、注意事項。
但呢啲嘢模型全部識,寫咗等於浪費上下文,仲會沖淡真正有價值嘅信息。
假設你寫緊一個處理代碼合併嘅技能,有兩種寫法:
寫法一,工程師本能寫法:
git log          # 找到提交
git checkout main
git checkout -b <新分支>
git cherry-pick <提交>
寫法二,Perplexity 建議嘅做法:
「將呢個提交到一個乾淨嘅分支上。解決衝突時保留原始意圖。如果真係合唔到,解釋原因。」
模型用後者嘅表現遠遠好過前者。
第一種寫法喺出問題時可能會令模型卡住,因為太過強制性嘅指定反而限制咗模型嘅發揮,指令遵守得越好嘅模型,限制越強,好可能後續執行命令序列時斷咗就完全唔知點算。
第二種寫法只俾咗意圖,等模型自己諗辦法。
呢點就非常違反常理,但如果細心諗下,又非常正確。
其實唔止 Skills,同 AI 對話同編程都係咁,AI 會非常順從你嘅思路,嚴格遵守你嘅指令同提示詞嚟完成任務,但同低水平對手捉棋越捉越差一樣道理,你嘅認知高度會限制模型嘅上限。
所以喺用 Claude Code 嘅時候,我會刻意提出一個非常模糊嘅需求,然後等佢提供多種路徑嘅方案,最後我先從呢啲方案入面比較同選擇,從而激發模型本身嘅潛能。
上下文係有成本嘅,每一層都喺度燒錢
Perplexity 將技能嘅加載開銷分成三層,呢個分法非常清晰,比官方文檔清楚得多。
第一層係索引層。
每個技能嘅名稱加描述,唔理用戶問乜,每次對話都要畀呢個成本。
佢哋嘅預算係每個技能大約 100 個 token,越短越好。
因為呢個成本乘以用戶,再乘以每日嘅對話次數,累積起嚟就係一個好大嘅數字。
第二層係正文層。
技能主體,理想係控制在 5000 token 之內。
一旦加載,就要撐到上下文壓縮 Compact。
一次對話通常會同時加載三到五個技能,成本疊加起嚟非常可觀。
技能裏面嘅描述廢話唔只浪費自己嘅空間,浪費 Token,仲會壓縮其他技能嘅發揮空間。
其實呢種講法非常啱,Skills 唔可以當作文檔咁用,唔好乜都堆曬落 Skills 度。
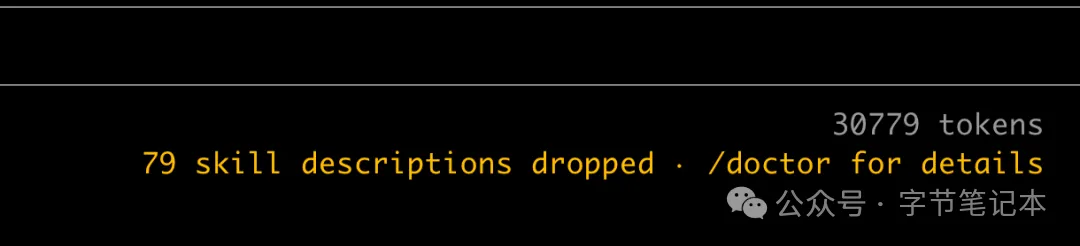
Claude Code 官方似乎都留意到呢點,新版本更新後會壓縮 Skills 嘅加載,通過 Warning 提示嚟警告你。
好似圖咁,我開 Claude Code 會話嘅時候,79 個 Skills 嘅描述就直接被 drop 咗,呢個係因為大量測評同書寫 Skills,堆積咗近百個 Skills,呢點唔好同我學。
之前陸續發佈過嘅 Skills 都放喺下面嘅網址度,有需要可以自取:
https://link.bytenote.net/note
第三層係運行層。
腳本、參考文檔、輸出模板呢啲附屬文件,只有模型真係需要時先讀取。
呢一層冇上限,因為都係按需加載,可以自由增補。
Perplexity 引用咗帕斯卡嘅經典語錄:
「我將呢封信寫得咁長,只係因為我冇時間將佢寫短。」
寫一個好技能同寫一封好信係同一件事。短唔係懶,短係功夫。
如果一個技能好容易寫出嚟,好大機會係寫多咗,或者根本唔需要佢。
描述係最難寫嗰個
Skill 技能嘅描述唔係說明文檔,佢嘅真正作用係路由觸發器。
模型靠佢決定要唔要加載呢個技能。
佢哋嘅格式要求好簡單:
以「當……時加載」開頭,目標 50 詞以內,用真實用戶講嘢嘅方式寫,唔好用工程師寫文檔嘅方式寫。
舉個例。
一個用嚟監控代碼合併請求嘅技能,兩種描述:
差嘅寫法:
監控代碼合併請求嘅狀態,支持查看進度同審查結果。
好嘅寫法:
當用戶想睇實一個合併請求順利完成、或者擔心流水線死咗嘅時候加載。關鍵詞:幫我睇實、確保呢個可以合入去、唔好俾佢卡住。
分別喺邊?
前者描述嘅係技能做到啲乜,後者描述嘅係用戶把口會講啲乜。
模型匹配嘅係後者,唔係前者,因為模型真正匹配嘅係關鍵詞同關鍵詞嘅密度,你可以覆蓋到嘅點越多,咁自然,Skills 就會好容易俾人路由到。
有啲嘢模型學唔到,只能夠你嚟寫
呢一個細節可以話係全文嘅精要所在。
Perplexity 有一套同設計相關嘅技能,係佢哋嘅設計負責人 Henry 親自寫嘅。
內容包括用邊啲字體、唔用邊啲字體,以及呢啲字體嘅「感覺」係乜。
一個好奇怪、好抽象嘅詞,感覺。
點解要寫呢個感覺呢?
因為呢個係審美判斷,唔係知識點。
模型可以知道 Helvetica 字體係乜,但佢完全唔能夠理解呢個字體喺咩場景下顯得好 low。
講到呢點就好想笑,每次新模型出嚟,一啲營銷帳號就開始用佢嚟製作頁面,話佢審美點樣點樣。
其實模型本身根本冇審美嘅能力,佢所有嘅「審美」都係依賴於機率同使用者嘅品味。
即係話,就算俾我用最早嘅 Deepseek V3,一樣可以原樣復原嗰啲所謂「審美強」嘅頁面。
真正嘅審美判斷嚟自經驗同品味,訓練數據都係死嘅,都可以透過技能注入出嚟。
Skills 技能最大嘅價值,唔係話俾模型知點樣做佢已經識嘅事,而係將你腦入面嗰啲講唔清楚但確實存在嘅判斷,變成模型用到嘅上下文。
反面案例比正面案例更加值錢
文章最後講技能維護,又係一個違反常理嘅結論。
文章非常明確咁指出技能嘅迭代模式應該係「只增不改」,而且主要向反面案例區域追加內容。
佢哋嘅做法係每次模型出錯,加一條反面案例,呢個時候唔好改描述,唔好加新規則,加反面案例就夠。
點解反面案例比正面案例更加有價值?
因為佢直接話俾模型知呢條路行過,係死路,唔好再行。正面案例話俾模型知向邊度行,反面案例話俾模型知邊度有坑,後者嘅信息密度往往更高。
佢哋仲提到一個好重要嘅副作用:加一個新技能,可能會令已有嘅技能變差。因為索引層嘅描述都在爭奪模型嘅注意力,兩個描述相近嘅技能會互相干擾。
所以每次新增技能,都要跑一次已有技能嘅測試,確認冇連帶破壞。
我覺得呢篇文檔值得反覆睇,而且唔好限制於書寫 Skills,完全可以將佢應用到模型對話嘅方方面面。
最後一句話送畀仲將技能當說明文檔咁寫嘅人:
如果模型冇呢個技能都做到啱,就唔需要呢個技能。
Claude Code 有十個最值得裝嘅 Skills!呢篇全部補上
將 Claude Design 蒸餾成可重用嘅幻燈片、原型、動畫、落地頁嘅 Skills
更多 Skills 嘅進階系統學習同分享請查看字節筆記本星球嘅每日推送:
Perplexity 最近公開了一篇內部工程文檔,講他們怎麼設計、迭代和維護 Agent Skills庫。
原文地址如下:
https://link.bytenote.net/DapXMD
Perplexity的產品做得稀碎,但這篇文檔把如何寫Skills這件事卻是講得比任何人都要好。
文章中的結論幾乎每一個都反直覺,但是如果細品就會發現異常合理,值得我們借鑑和實踐。
比如開頭引用類比Python 之禪這本書,講Python 的設計哲學是"簡單優於複雜"、"明確優於隱式",但是在寫技能時就完全不是那麼回事。
“如果一件事很容易解釋,說明模型早就知道了。刪掉它。”
文檔直指要害。我們寫技能時最大的本能錯誤,就是把它當說明文檔寫。
各種列命令、列步驟、列注意事項。
但這些東西模型全會,寫了等於浪費上下文,還會稀釋真正有價值的信息。
假設你在寫一個處理代碼合併的技能,兩種寫法:
寫法一,工程師本能寫法:
git log          # 找到提交
git checkout main
git checkout -b <新分支>
git cherry-pick <提交>
寫法二,Perplexity 建議的做法:
“把這個提交到一個乾淨的分支上。解決衝突時保留原始意圖。如果實在合不進去,解釋原因。”
模型用後者的表現要遠好於前者。
第一種寫法在出問題時可能會讓模型卡殼,因為過於強制性的指定反而限制了模型的發揮,指令遵守越好的模型,限制越強,很可能後續執行命令序列時斷了就完全無所適從了。
第二種寫法只給了意圖,讓模型自己想辦法。
這點就非常的反直覺,但是如果細想,又非常的正確。
其實不只是Skills,在和AI的對話和編程當中也是如此,AI會非常的順從你的思路,嚴格遵守你的指令和提示詞來完成任務,但和臭棋簍子下棋越下越臭一樣道理,你的認知高度會限制模型的上限。
所以在使用Claude Code的時候,我會刻意的提出一個非常模糊的需求,然後讓它來提供多種路徑的方案,最後我才從這些方案當中去比較和選擇,從而激發出模型本身的潛能。
上下文是有成本的,每一層都在燒錢
Perplexity把技能的加載開銷分成三層,這個分法非常清晰,比官方文檔明瞭多了。
第一層是索引層。
每個技能的名稱加描述,不管用戶問什麼,每次對話都在付這個成本。
他們的預算是每個技能約 100 個 token,能短則短。
因為這個成本乘以用戶,再乘以每天的對話次數,累積起來就是一個很大的數字。
第二層是正文層。
技能主體,理想控制在 5000 token 以內。
一旦加載,就要扛到上下文壓縮Compact。
一次對話通常會同時加載三到五個技能,成本疊加起來非常可觀。
技能裏的描述廢話不只是浪費自己的空間,浪費Token,還會壓縮其他技能的發揮餘地。
其實這種說法非常的對,Skills不能夠當做文檔來使用,不要事無鉅細的全部都堆積到Skills當中。
Claude Code官方似乎也注意了這點,新版本更新後會壓縮Skills的加載,通過Waring提示來警告你。
如圖所示,我在開啓Claude Code會話的時候,79個Skills的描述就直接被drop掉了,這是因為大量測評和書寫Skills,堆積了近百個Skills,這點不用跟我學。
之前陸續發佈過的Skills都被放在如下的地址裏面,如有需要可以自取:
https://link.bytenote.net/note
第三層是運行層。
腳本、參考文檔、輸出模板這些附屬文件,只有模型真正需要時才讀取。
這一層沒有上限,因為都是按需加載,可以自由增補。
perplexity引用了帕斯卡的經典語錄:
“我把這封信寫得這麼長,只是因為我沒有時間把它寫短。“
寫一個好技能和寫一封好信是同一件事。短不是懶,短是功夫。
如果一個技能很容易寫出來,大概率是寫多了,或者根本不需要它。
描述是最難寫的那個
Skill技能的描述不是說明文檔,它的真正作用是路由觸發器。
模型靠它決定要不要加載這個技能。
他們的格式要求很簡單:
以"當……時加載"開頭,目標 50 詞以內,用真實用戶說話的方式寫,不要用工程師寫文檔的方式寫。
舉個例子。
一個用來監控代碼合併請求的技能,兩種描述:
差的寫法:
監控代碼合併請求的狀態,支持查看進度和審查結果。
好的寫法:
當用戶想盯着一個合併請求順利落地、或者擔心流水線掛掉時加載。關鍵詞:幫我盯着、確保這個能合進去、別讓它被卡住。
區別在哪?
前者描述的是技能能做什麼,後者描述的是用戶嘴裏會說什麼。
模型匹配的是後者,不是前者,因為模型真正去匹配的是關鍵詞以及關鍵詞的密度,你可以覆蓋到的點越多,那麼自然,Skills就會非常容易的被路由到。
有些東西模型學不到,只能你來寫
這一個細節可以說是全文的精要所在。
Perplexity 有一套設計相關的技能,是他們的設計負責人 Henry 親自寫的。
內容包括用哪些字體、不用哪些字體,以及這些字體的"感覺"是什麼。
一個很奇怪的、很抽象的詞,感覺。
為什麼要寫這個感覺呢?
因為這是審美判斷,不是知識點。
模型可以知道 Helvetica 字體是什麼,但是它完全不能理解這個字體在什麼場景下顯得非常的low。
說到這點就非常的想笑,每次新模型出來,一些營銷號就開始用它來製作頁面,說它審美如何如何。
其實模型本身根本不具備審美的能力,它所有的“審美”都是依賴於概率和使用者的品味。
也就是說,哪怕讓我使用最早期的Deepseek V3,照樣也可以原樣復原那些所謂“審美強“的頁面。
真正的審美判斷來自經驗和品味,訓練數據都是死的,都可以通過技能注入進來。
Skills技能最大的價值,不是告訴模型怎麼做它已經會的事,而是把你腦子裏那些說不清楚但確實存在的判斷,變成模型能用的上下文。
反面案例比正面案例更值錢
文章最後講技能維護,又是一個反直覺的結論。
文章非常明確地指出技能的迭代模式應該是"只增不改",而且主要往反面案例區域追加內容。
他們的做法是每次模型出錯,加一條反面案例,這個時候不要改描述,不要加新規則,加反面案例就夠了。
為什麼反面案例比正面案例更有價值?
因為它直接告訴模型這條路走過,是死路,不要再走,正面案例告訴模型往哪走,反面案例告訴模型哪裏有坑,後者的信息密度往往更高。
他們還提到了一個很重要的副作用:加一個新技能,可能會讓已有的技能變差。因為索引層的描述都在爭奪模型的注意力,兩個描述相近的技能會互相干擾。
所以每次新增技能,都要跑一遍已有技能的測試,確認沒有連帶破壞。
我覺得這篇文檔值得反覆讀,而且不要限制於書寫Skills,完全可以把它應用到模型對話的方方面面。
最後一句話送給還在把技能當說明文檔寫的人:
如果模型沒有這個技能也能做對,就不需要這個技能。
Claude Code 又十個最值得裝的 Skills!這篇全補上
將Claude Design蒸餾成可複用的幻燈片、原型、動畫、落地頁的Skills
更多Skills的進階系統學習和分享請查看字節筆記本星球的每日推送: