為什麼要用 llm_wiki 來創建和管理你的知識體系?
整理版優先睇
llm_wiki 唔係普通 AI 知識庫,而係一個幫你將雜亂文檔自動整理成可持續生長 Wiki 嘅知識建設工具。
呢篇文章介紹一個開源項目 llm_wiki,佢係基於 Andrej Karpathy 嘅方法論落地嘅桌面應用。作者指出,好多人收集咗大量資料,但最終只係一堆堆積,欠缺真正嘅知識體系——資料係堆積,知識體系係結構;資料存得到,知識體系先調用得到。
llm_wiki 嘅目標係將你嘅分散文檔轉化為一個會自主生長、互聯互通嘅個人知識庫。佢內建大語言模型處理流程同向量檢索,可以自動生成知識圖譜、頁面連結同內容概述。同 Obsidian 呢類筆記工具唔同,llm_wiki 預設就有 AI 整合,唔需要靠插件擴展。
作者認為,真正好嘅知識體系唔係「全」,而係「活」——隨住你輸入不斷更新,將新材料同舊知識連結,慢慢長成一個完整認知地圖。llm_wiki 嘅價值在於將你從知識搬運工解放出來,讓你專注高階判斷,而 AI 負責基礎整理同結構維護。
- 資料同知識體系嘅分別在於有冇結構同可調用性。
- llm_wiki 核心唔係即時問答,而係長期沉澱嘅知識建設。
- 用 Wiki 形式天然適合組織主題化知識網絡。
- AI 幫手做基礎整理,用家專注高階判斷。
- 真正好嘅知識體系係「活」嘅,會隨輸入持續生長。
資料堆積 vs 知識體系
好多人用 Notion、Obsidian 儲咗幾百篇 PDF、上千個網頁,但用用嚇就會發現:你擁有嘅唔係知識體系,而係一堆資料。兩者之間差得好遠:資料係堆積,知識體系係結構;資料係存落嚟,知識體系係能調用;資料俾你安全感,知識體系先真正幫到你思考。
你擁有嘅唔係知識體系,而係一堆資料
- 資料係堆積,知識體系係結構。
- 資料係存落嚟,知識體系係能調用。
- 資料俾你安全感,知識體系先真正幫到你思考。
llm_wiki 係咩?同 Obsidian 有咩分別?
llm_wiki 係一個跨平台桌面應用,根據 Andrej Karpathy 嘅方法論落地。佢嘅目標係將雜亂文檔自動轉化為一個會自主生長、互聯互通嘅個人知識庫。同 Obsidian 唔同,llm_wiki 內建大語言模型處理流程同可選向量檢索能力,唔需要靠插件擴展。
內建大語言模型處理流程同可選向量檢索能力
- 1 接入大模型(官方或自定義),可以喺知識問答區根據知識庫準確回答。
- 2 接入向量模型(例如硅基流動免費模型),支援 DeepSearch 同自動判斷知識完整性。
- 3 文件上傳管理:可以上傳單個文件或整個文件夾。
- 4 嚴格跟三層管理分類,自動生成知識圖譜。
最終目的係同 Obsidian、Claude Code 或 OpenClaw 配合使用,形成高效協同。
核心思路:建設知識體系,而唔係回答問題
好多 AI 知識庫嘅邏輯係「你上傳材料,然後提問,系統根據檢索結果俾答案」。呢種做法似一個臨時答題器,每次組織一次,唔會真正沉澱知識。
可以持續加工嘅知識原料
- 前者強調即時響應,後者強調長期沉澱。
- 前者係問答工具,後者更接近知識建設工具。
呢種轉變令你唔再只係「問 AI」,而係「同 AI 一齊建設知識體系」。
真正改變:AI 幫你做體力活,你專注高階判斷
以前知識管理流程好重:收集、手動睇、手動記、手動分類、手動建立聯繫,最後希望形成體系。門檻高,好難堅持。
AI 幫你從知識搬運工同結構體力活解放出來
- 1 判斷哪些內容值得進入體系
- 2 決定呢個體系服務咩目標
- 3 審核 AI 建出嚟嘅結構係咪合理
- 4 喺關鍵節點加入你自己嘅理解同觀點
咁樣你就可以將精力用喺更高層級嘅認知工作上,而唔係做資料搬運。
開始行動:由一個主題入手,唔好追求完美
好多人都等工具完美先開始,但真正重要嘅係由「信息收集」升級做「知識組織」。建議由一個明確主題開始,例如 AI 產品、個人寫作、投資研究等。
由一個明確主題開始
- 集中相關資料,俾系統生成初步結構、頁面、關係連結同概覽。
- 不斷補充、修正、刪改、重連——知識體系係喺「AI 協助 + 人工判斷」循環中長出嚟嘅。
- 唔好追求一次成型,要俾佢持續生長。
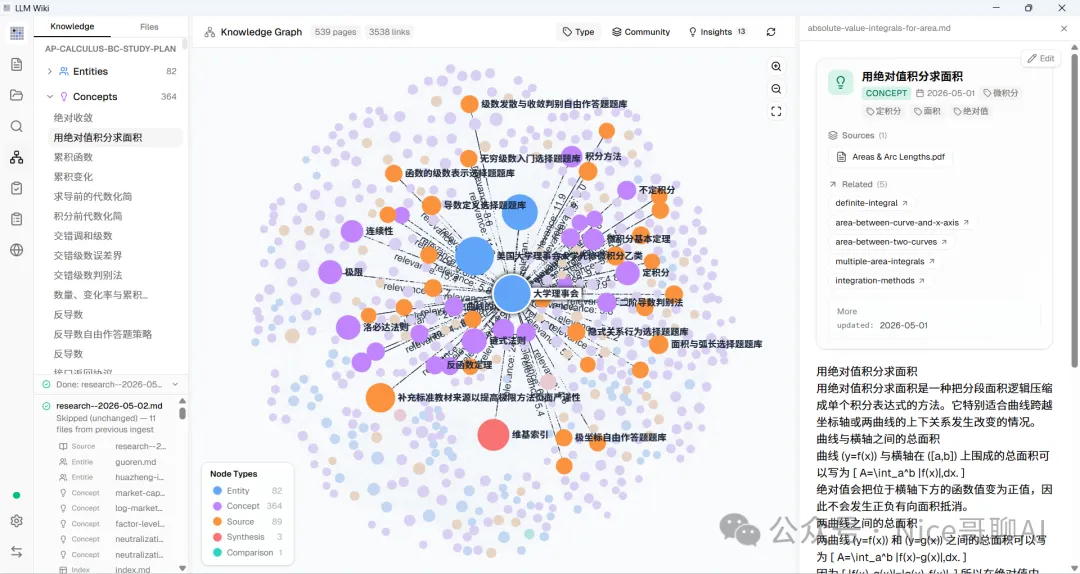
呢兩年,個個都喺度講「個人知識庫」。
有人用 Notion,有人用 Obsidian,有人囤咗幾百篇 PDF、收藏咗上千個網頁、記咗幾萬字筆記。睇落資料越嚟越多,系統越嚟越齊,但好多人用用嚇都會遇到同一個問題:
你擁有的唔係知識體系,你只係擁有一堆資料。
呢兩者之間,相差唔只一點點。
• 資料係堆積,知識體系係結構。 • 資料係存低,知識體系係用得着。 • 資料令你有安全感,知識體系先至真正幫到你思考。
所以問題嚟喇:
我哋到底應該點樣將「收集返嚟嘅資訊」,真正變成「可以生長、可以連接、可以重用嘅知識體系」?
最近我見到一個開源項目,叫 llm_wiki。呢個唔係Andrej Karpathy嗰個,而係根據佢嘅方法論落地咗一款跨平台桌面應用,旨在將雜亂文檔自動轉化為一個會自主生長、互聯互通嘅個人知識庫。佢畀我嘅感覺唔係「又一個 AI 工具」,而係好似認真回答呢個問題:
可唔可以令 AI 唔只係幫你揾資料、答問題,而係幫你將分散嘅文檔,慢慢變返一個真正嘅知識系統?
如果你都喺度做筆記、建知識庫、囤資料,或者一直想搭一個屬於自己嘅「第二大腦」,呢個項目好值得睇嚇。
下文為咗方便講解,我哋暫時叫佢llm_wiki吧!
一、llm_wiki係咩嘢?
佢嘅安裝方法已經喺上一篇《如何令Obsidian、llm_wiki、OpenClaw高效協同?》同大家講過,呢度唔再重複,不過有啲朋友可能會話,你呢個嘢唔係同Obsidian一樣咩?咁直接用Obsidian就得啦,搞呢啲嘢做咩?非也!有相同點,但佢哋唔係同一樣嘢。
同Obsidian嘅分別:
• llm_wiki 比起 Obsidian,更加似一個內建咗大語言模型處理流程同可選向量檢索能力嘅知識庫生成系統。 • Obsidian 默認唔自帶呢啲能力,要靠插件或外部工具擴展。
佢有啲咩功能?• 接入大語言模型
可以揀官方模型,亦可以用自定義模型,下面係自定義模型設定。
接入大語言模型之後,可以喺知識問答區向佢提問,佢會根據已經建立好嘅知識庫,進行準確回答。• 接入向量模型
我接入嘅係硅基流動嘅免費模型,大家可以參考呢啲參數嚟設定。• DeepSearch功能同創建頁面
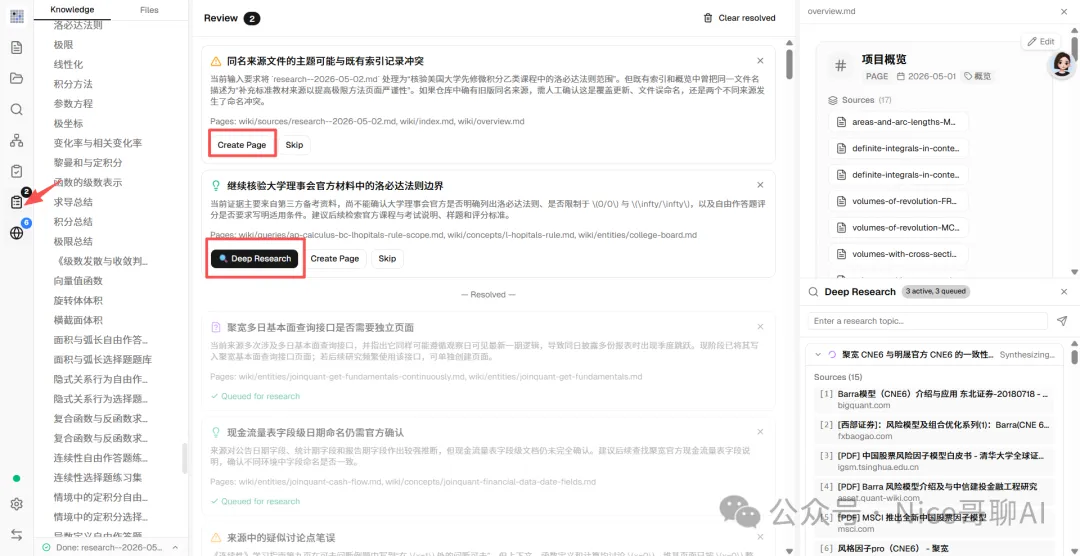
自動判斷知識係咪完整,如果需要進行深入研究或創建新嘅頁面,就會喺呢個界面提醒。• 文件上傳管理
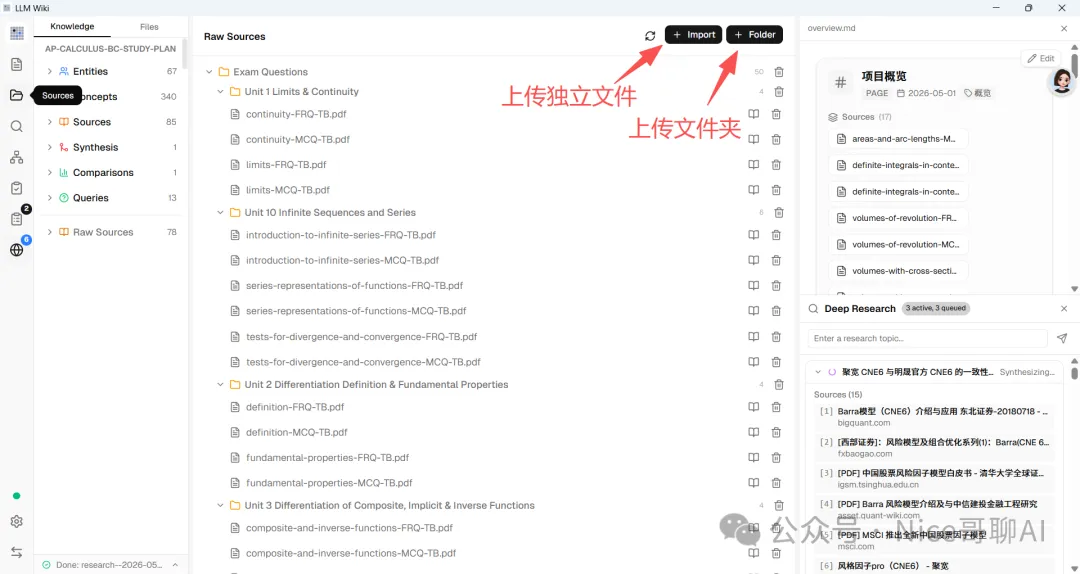
可以喺呢個頁面入面,喺本地揀選上傳單獨文件或者整個文件夾嘅文件。• 知識庫管理
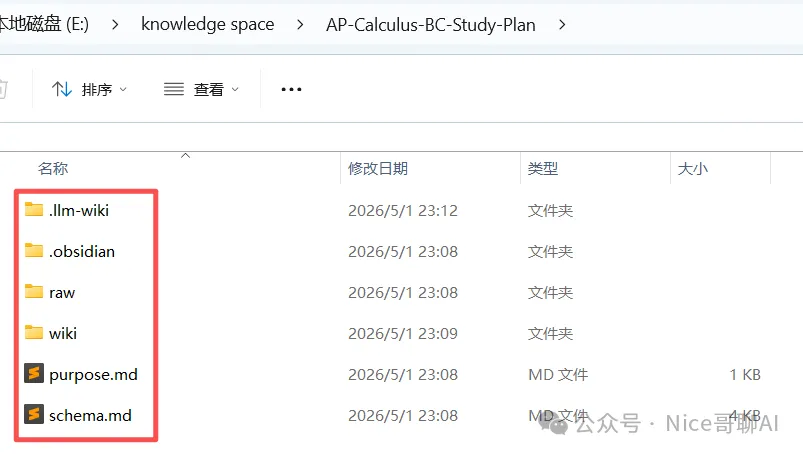
佢對文件嘅管理,係嚴格按照Andrej Karpathy嘅方法論嘅三層管理嚟分類整理。
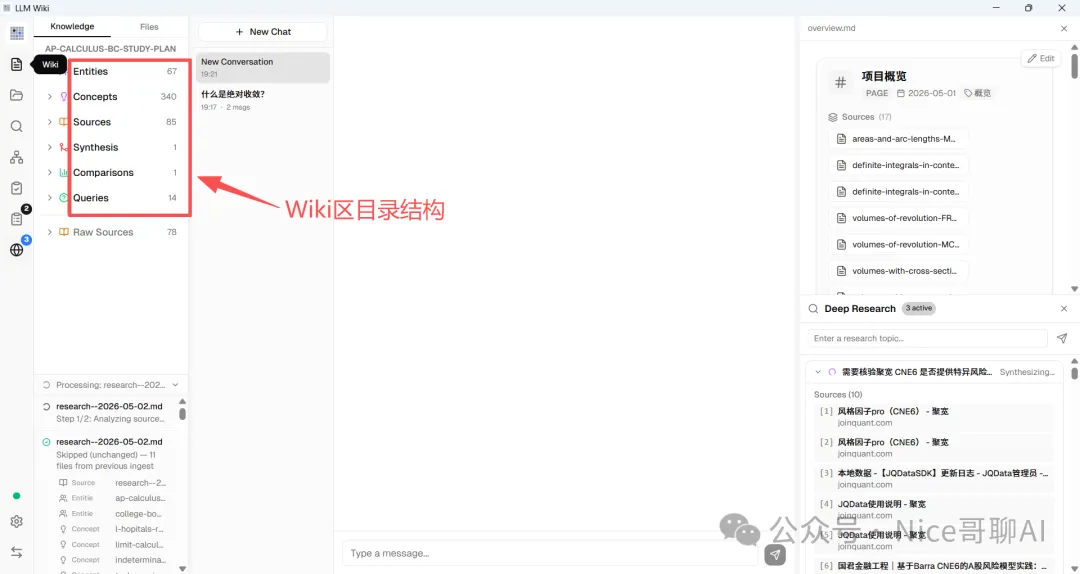
軟件入面嘅文件目錄結構:• 生成知識圖譜
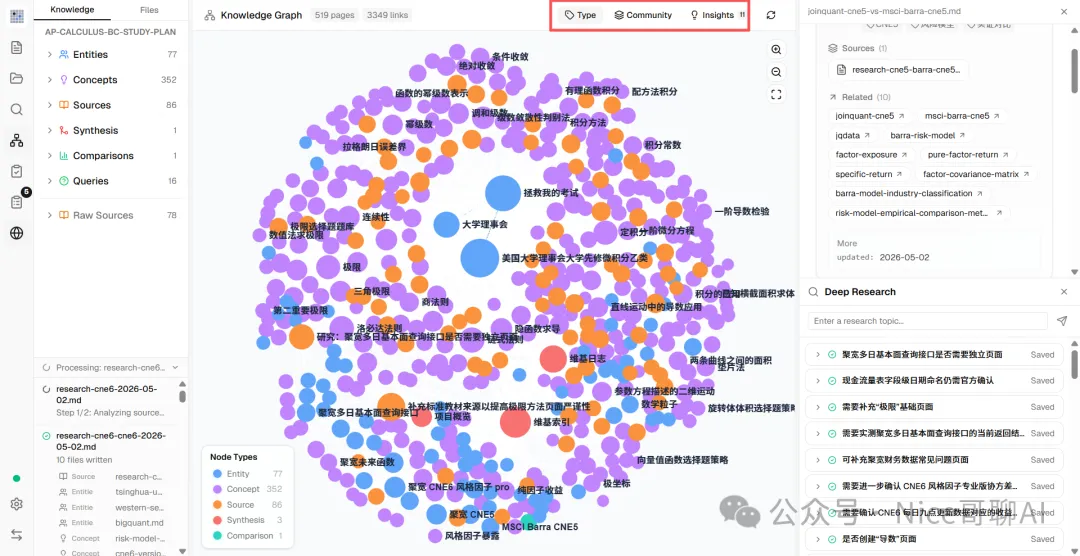
呢個知識圖譜嘅產生,係利用前面嘅大語言模型同向量模型自動處理生成嘅,成個過程由佢自動完成。因為要對上傳嘅文件做向量化處理,所以成個處理過程好慢。不過有一點可以保證,你第二朝起身,佢一定處理得完!• 文件預覽
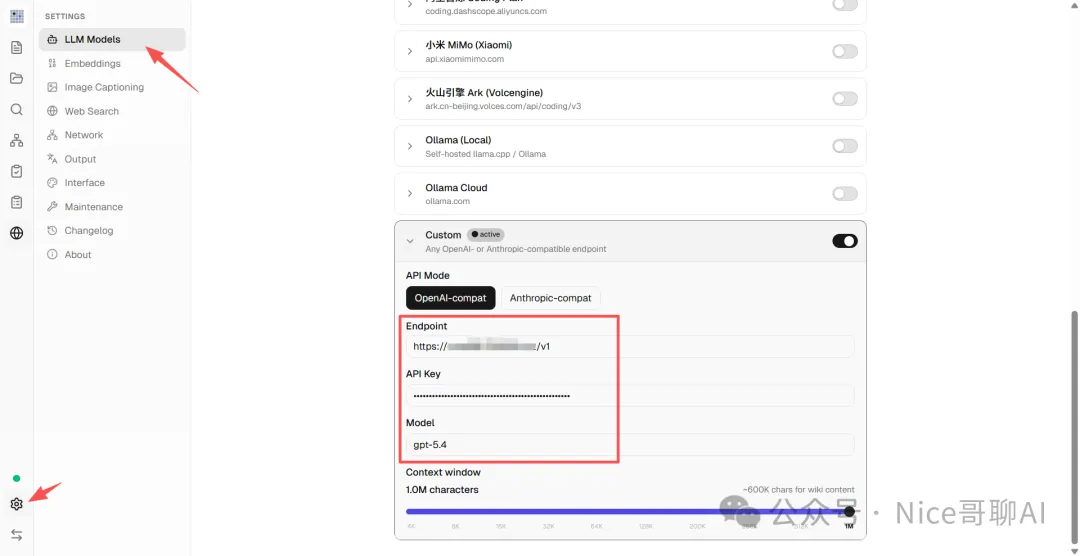
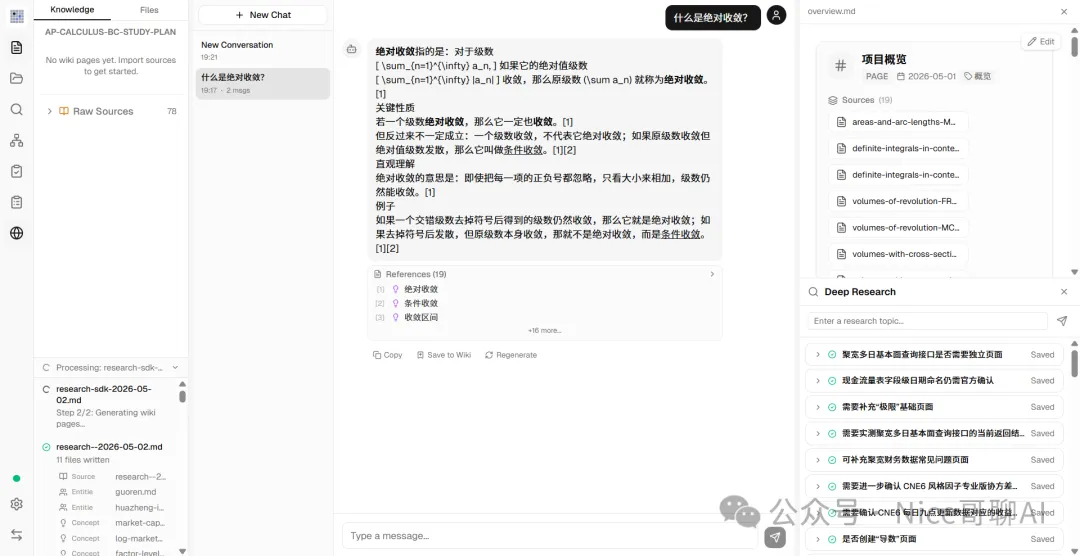
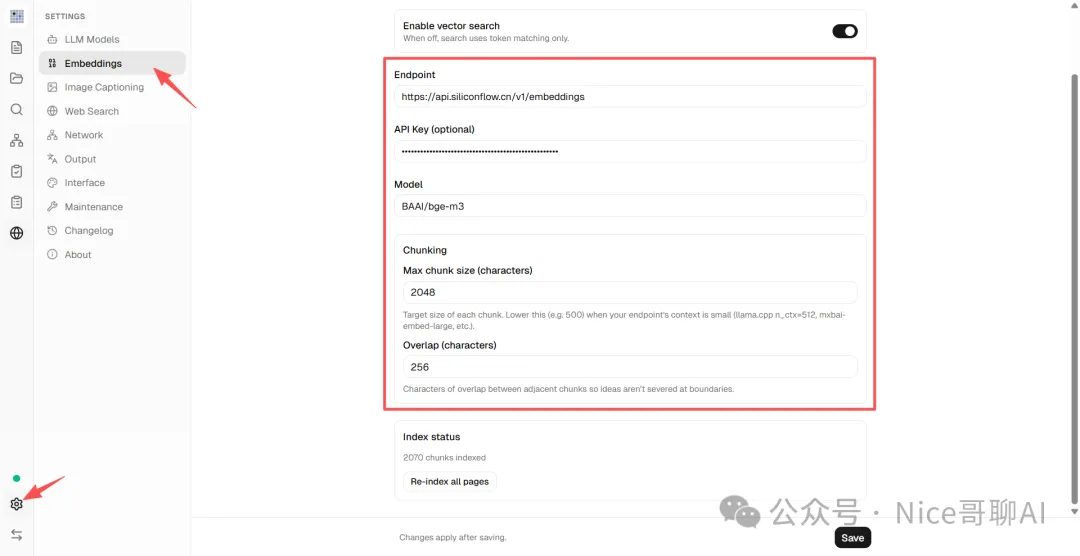
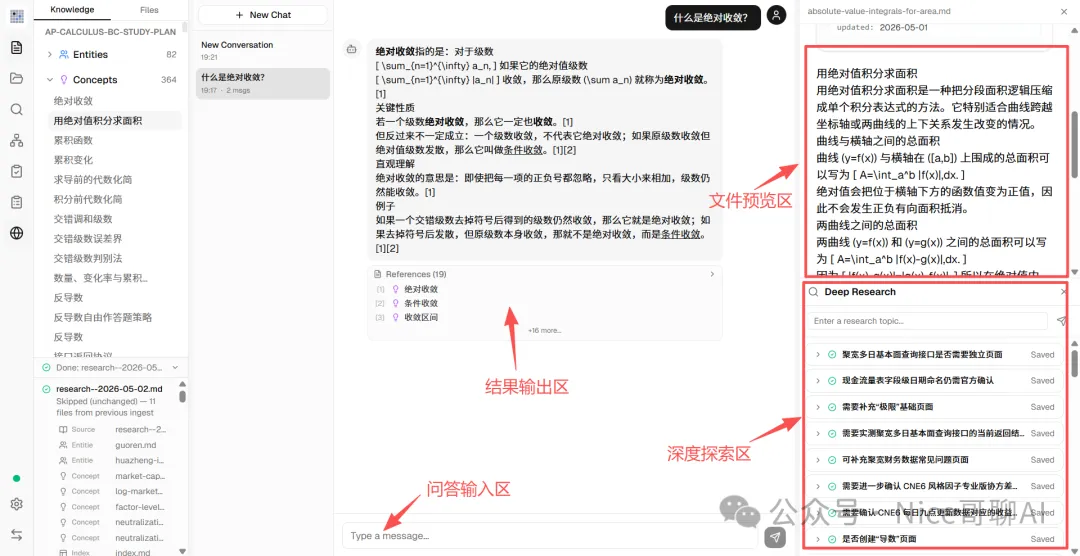
基本功能就係咁多,同Obsidian嘅界面差唔多,最終目的都係要同Obsidian或claude code或OpenClaw配合使用,上篇我哋已經講過啦!
跟住我哋嚟傾嚇佢有啲咩唔同,點解要用佢!
二、點解大多數人嘅「知識庫」,最後都變咗資料倉庫?
好多人對知識管理嘅第一反應,都係「先收集」。
• 見到好文章,儲低。 • 見到好 PDF,下載。 • 見到好觀點,摘錄。 • 見到課程資料、會議記錄、研究報告,都統統放埋一齊。
久而久之,你嘅硬碟、雲端、筆記軟件入面,的確會越來越滿。
但「越來越滿」唔等於「越來越識」。
因為真正嘅問題,從來唔係資訊太少,而係資訊之間冇關係。
• 你知道某個觀點喺邊篇文章入面。 • 你記得某份報告入面有個關鍵數據。 • 你收藏過好多相關資料。
但當你真係要寫一篇文章、做一個報告、研究一個主題嘅時候,你會發現:
• 呢啲內容彼此冇連埋一齊。 • 佢哋冇形成穩定嘅結構。 • 佢哋冇變返一個你隨時可以調用嘅認知網絡。
呢個亦都係點解好多人嘅知識管理,最後都會停留喺「存檔」層面。
表面睇好努力,實際上調用效率並唔高。
三、問題唔在於你記嘅唔夠多,而在於冇形成「知識之間嘅連結」
真正有用嘅知識體系,唔係睇你儲咗幾多,而係睇你識唔識將知識之間嘅關係組織出嚟。
譬如你研究 AI,唔只係收集十篇關於大模型嘅文章。
更加重要的是你知唔知道:
• 邊啲內容係講基礎原理 • 邊啲內容係講應用場景 • 邊啲內容係講工具鏈 • 邊啲內容之間觀點有衝突 • 邊啲材料其實可以拼成同一個研究主題 • 邊啲問題你仲未諗通
呢個時候你會發現,知識體系嘅關鍵,唔係「記筆記」,而係【「建連結」】。
即係話,單條資訊嘅價值係有限嘅。
但係一旦資訊之間開始發生連接,知識先會開始顯現出結構。
呢個亦都係點解好多人用咗雙鏈筆記、卡片筆記之後,會突然覺得思路更加清晰。
因為你唔再只係保存內容,而係喺度搭建一個「關係網絡」。
而 llm_wiki 想做嘅,就係將呢件事往前推一步:
唔係完全靠你手動整理、手動連結、手動歸類,
而係令 AI 參與埋嚟,幫你將呢啲文檔自動梳理成一個持續生長嘅 Wiki。
四、llm_wiki 嘅核心思路,唔係「回答問題」,而係「建設知識體系」
呢個亦都係呢個項目最令我眼前一亮嘅地方。
今日好多 AI 知識庫嘅邏輯都係一樣嘅:
你上傳材料,然後提問,系統根據檢索結果畀你答案。
呢個當然有用。
但佢更加似一個「臨時答題器」。
• 你問一次,佢組織一次。 • 你再問一次,佢再組織一次。
佢的確可以回答問題,但佢未必真係幫你將知識沉澱低。
而 llm_wiki 嘅思路有啲唔同。
佢唔係將文檔當成一次一次檢索嘅素材庫,
而係將文檔當成【「可以持續加工嘅知識原料」】。
AI 讀完呢啲內容之後,唔只係畀你一個答案,
而係嘗試將佢哋整理成:
• 有結構嘅頁面 • 可以互相跳轉嘅連結 • 帶來源追蹤嘅內容 • 可以持續更新嘅知識圖譜 • 能夠反映整體認知狀態嘅 Wiki 系統
你可以理解成:
普通 AI 知識庫,係「你問,AI 答」。
而 llm_wiki 更加似「AI 先幫你將知識整理好,你再喺呢個結構上繼續思考」。
呢兩種方式,表面睇都係用 AI,
但底層邏輯完全唔同。
• 前者強調即時回應,後者強調長期沉澱。 • 前者係問答工具,後者更接近知識建設工具。
五、點解「Wiki」呢個方向,天然適合搭知識體系?
好多人會將 Wiki 理解為一個老派嘅文檔形式。
但如果你真係想搭知識體系,你會發現 Wiki 其實好適合呢件事。
因為 Wiki 有幾個天然優勢:
1. 佢強調頁面之間嘅關係。
唔係一篇篇孤立嘅筆記,而係一張可以不斷延伸嘅知識網絡。2. 佢天然支持主題化組織。
一個概念、一位人物、一個方法論、一個項目,都可以成為獨立頁面,再彼此關聯。3. 佢適合持續迭代。
知識體系唔係一次寫完嘅,而係喺不斷閲讀、理解、連接、修正之中慢慢長出嚟嘅。4. 佢更加適合「由局部走向整體」。
你今日只整理一頁,聽日再補兩頁,後日補一條連結,最後就可能變成一個完整嘅認知地圖。
所以從呢個角度睇,llm_wiki 個名其實已經講咗佢嘅方向:
唔係做一個會傾偈嘅 AI,
而係做一個會幫你長 Wiki 嘅 AI。
呢件事嘅價值在於,佢令「知識體系建設」由一件高門檻、重手工嘅事,慢慢變成一件可以被 AI 協助完成嘅事。
六、用 llm_wiki 創建知識體系,真正改變嘅係咩?
如果只係「自動整理文檔」,咁呢個項目其實冇乜特別。
但佢真正改變嘅,係你同知識之間嘅工作關係。
以前嘅流程通常係咁樣:
1. 你收集資料。 2. 你手動睇。 3. 你手動記。 4. 你手動分類。 5. 你手動建立聯繫。 6. 最後,你希望有一日呢啲內容可以形成體系。
呢套流程嘅問題唔係錯,而係太重了。
佢對執行力、耐性、長期維護能力嘅要求都好高。
好多人唔係唔識做,而係堅持唔到。
而 llm_wiki 提供嘅,係另一種可能:
你依然負責輸入材料、提出目標、做關鍵判斷;
但大量基礎性嘅整理、歸類、連結、生成概覽、維護結構,可以交畀 AI 去完成。
呢個意味住,你可以將更多精力放喺真正重要嘅事上面:
• 判斷邊啲內容值得進入體系 • 決定呢個體系服務啲咩目標 • 審核 AI 建出嚟嘅結構係咪合理 • 喺關鍵節點加入你自己嘅理解同觀點
講得直接啲:
AI 唔係幫你思考,
而係將你由「知識搬運工」同「結構體力活」入面解放出嚟,令你可以將精力用喺更高層次嘅認知工作上面。
呢個先係佢對「知識體系建設」最現實嘅價值。
七、真正好嘅知識體系,唔係「全」,而係「活」
好多人一講到知識管理,就容易陷入一個誤區:
成日想將所有嘢都收埋入去,成日想一次過搭成一個完美系統。
但知識體系從來唔係靠「全收集」贏嘅,
而係靠【「持續生長」】贏嘅。
一個真正有生命力嘅知識體系,應該係咁樣:
• 佢會隨住你嘅輸入不斷更新 • 佢會隨住你嘅關注重點調整結構 • 佢會將新材料同舊知識連接埋一齊 • 佢能夠令你逐漸發現盲區、斷點同未完成嘅問題
從呢個意義上講,知識體系唔係書架,
更像花園。
• 書架係將嘢擺上去。 • 花園係令嘢生起嚟。
而 llm_wiki 最有意思嘅地方,就係佢明顯更接近 「花園型知識系統」。
你輸入文檔,佢唔係簡單堆埋;
佢會嘗試整理、連結、更新、擴展。
如果呢個過程做得夠穩定,佢帶來嘅唔只係「整理效率提升」,而係認知方式嘅變化。
你會慢慢由「我儲咗好多嘢」,
轉向 變成「我真係有一套屬於自己嘅知識結構」。
八、如果你真係想搭自己嘅知識體系,可以從呢一步開始
我覺得好多人睇呢類項目,容易有一個誤區:
以為要等工具完美咗,自己先可以開始。
其實唔係。
真正重要嘅,唔係你有冇最強嘅工具,
而係你有冇開始將「資訊收集」升級做「知識組織」。
如果你想用 llm_wiki 嚟創建自己嘅知識體系,我反而建議由細位開始。
譬如你可以先圍繞一個明確主題:
• AI 產品 • 個人寫作 • 投資研究 • 健康管理 • 某個長期項目 • 某個專業領域嘅學習路徑
先將相關資料集中埋一齊,
然後令系統幫你生成初步嘅結構、頁面、關係連結同概覽。
接着你要做嘅,唔係追求「一次成型」,
而係不斷補充、修正、刪改、重新連接。
知識體系唔係生成出嚟嘅,
而是在 而係喺「AI 協助 + 人手判斷」 嘅循環入面長出嚟嘅。
呢個先係更現實,亦都更加可持續嘅方式。
九、寫喺最後
我哋成日以為,知識體系係一件好高級、好複雜、好麻煩嘅事。
所以好多人一諗到要「系統化整理」,就會本能拖延。
但本質上,知識體系不過係回答一個問題:
你個腦入面嗰啲重要嘢,可唔可以喺外部世界都長出結構?
以前,呢件事主要靠人自己一點一點搭建。
而家,好似 llm_wiki 呢類項目,畀咗我哋一個新嘅可能:
或者 AI 唔只係幫我哋更快揾到答案,
仲可以幫我哋更加持續咁建設認知本身。
呢個先係我認為佢真正值得關注嘅原因。
因為佢解決嘅,唔只係「點樣問 AI」,
而是 而係「點樣將你見到、學到、諗到嘅嘢,慢慢變成真正屬於你嘅知識體系」。
如果你手頭上已經有好多資料、好多筆記、好多想法,但一直冇形成結構,
咁或者可以試下由 llm_wiki 開始。
開始。唔好再只係囤資料喇。
去搭一個會生長嘅知識體系啦。
這兩年,大家都在談“個人知識庫”。
有人用 Notion,有人用 Obsidian,有人囤了幾百篇 PDF、收藏了上千個網頁、記了幾萬字筆記。看起來資料越來越多,系統越來越全,但很多人用着用着都會遇到同一個問題:
你擁有的不是知識體系,你只是擁有一堆資料。
這兩者之間,差得不是一點點。
• 資料是堆積,知識體系是結構。 • 資料是存下來,知識體系是能調用。 • 資料讓你有安全感,知識體系才能真正幫你思考。
所以問題來了:
我們到底該怎麼把“收集來的信息”,真正變成“可生長、可連接、可複用的知識體系”?
最近我看到一個開源項目,叫 llm_wiki。這個不是Andrej Karpathy的那個,而是根據他的方法論落地了一款跨平台桌面應用,旨在將雜亂文檔自動轉化為一個會自主生長、互聯互通的個人知識庫。它給我的感覺不是“又一個 AI 工具”,而更像是在認真回答這個問題:
能不能讓 AI 不只是幫你找資料、答問題,而是幫你把分散的文檔,慢慢長成一個真正的知識系統?
如果你也在做筆記、建知識庫、囤資料,或者一直想搭一個屬於自己的“第二大腦”,這個項目很值得看看。
下文為了方便講解,我們暫叫它llm_wiki吧!
一、llm_wiki是什麼?
它的安裝方法已經在上一篇《如何讓Obsidian、llm_wiki、OpenClaw高效協同?》給大家講過了,這裏不再贅述,可是有些小夥伴可能會說了,你這個東西不是和Obsidian一樣嗎?那直接使用Obsidian不就完了嗎?費這事幹嘛?非也!是有相同點,但他們不是一個東西。
與Obsidian的區別:
• llm_wiki 相比 Obsidian,更像一個內建了大語言模型處理流程和可選向量檢索能力的知識庫生成系統。 • Obsidian 默認不自帶這些能力,需要靠插件或外部工具擴展。
它有什麼功能?• 接入大語言模型
可以選擇官方模型,也可以使用自定義模型,下面是自定義模型設置。
接入大語言模型後,可以在知識問答區向它提問,它會根據已經建立好的知識庫,進行準確回答。• 接入向量模型
我接入的是硅基流動的免費模型,大家可以參考這些參數進行設置。• DeepSearch功能和創建頁面
自動判斷,知識的完整,如果需要進行深入研究或創建新的頁面,則會在此界面進行提醒。• 文件上傳管理
可以在此頁面中,在本地選擇上傳單獨文件或整個文件夾中的文件。• 知識庫管理
它對文件的管理,是嚴格按照Andrej Karpathy的方法論的三層管理進行分類整理的。
軟件中的文件目錄結構:• 生成知識圖譜
這個知識圖譜的產生,是利用前面的大語言模型和向量模型自動處理生成的,整個過程由它自動完成,由於需要對上傳的文件進行向量化處理,因此整個處理過程很慢。有是有一點可以保證,你第二天醒來,它一定能處理完!• 文件預覽
基本的功能就這麼多,和Obsidian的界面差不多,最終的目的也是讓它與Obsidian或claude code或OpenClaw配合使用,上篇我們已經講過啦!
接下來我們來聊一聊它有什麼不同,為什麼要用它!
二、為什麼大多數人的“知識庫”,最後都變成了資料倉庫?
很多人對知識管理的第一反應,都是“先收集”。
• 看到好文章,存。 • 看到好 PDF,下載。 • 看到好觀點,摘錄。 • 看到課程資料、會議記錄、研究報告,也統統放進去。
久而久之,你的硬盤裏、雲盤裏、筆記軟件裏,確實會越來越滿。
但“越來越滿”不等於“越來越懂”。
因為真正的問題,從來不是信息太少,而是信息之間沒有關係。
• 你知道某個觀點在哪篇文章裏。 • 你記得某份報告裏有個關鍵數據。 • 你收藏過很多相關資料。
但當你真的要寫一篇文章、做一個報告、研究一個主題時,你會發現:
• 這些內容彼此沒有連起來。 • 它們沒有形成穩定的結構。 • 它們沒有長成一個你隨時能調動的認知網絡。
這也是為什麼很多人的知識管理,最後都會停留在“存檔”層面。
看起來很努力,實際調用效率並不高。
三、問題不在於你記得不夠多,而在於沒有形成“知識之間的連結”
真正有用的知識體系,不是看你存了多少,而是看你能不能把知識之間的關係組織出來。
比如你研究 AI,不只是收集十篇關於大模型的文章。
更重要的是你是否知道:
• 哪些內容在講基礎原理 • 哪些內容在講應用場景 • 哪些內容在講工具鏈 • 哪些內容之間觀點衝突 • 哪些材料其實能拼成同一個研究主題 • 哪些問題你還沒有想透
這時候你會發現,知識體系的關鍵,不是“記筆記”,而是【“建連結”】。
也就是說,單條信息的價值是有限的。
但一旦信息之間開始發生連接,知識才會開始顯現出結構。
這也是為什麼很多人用了雙鏈筆記、卡片筆記之後,會突然覺得思路更清晰。
因為你不再只是保存內容,而是在搭一個“關係網絡”。
而 llm_wiki 想做的,就是把這件事往前推一步:
不是完全靠你手動整理、手動連結、手動歸類,
而是讓 AI 參與進來,幫你把這些文檔自動梳理成一個持續生長的 Wiki。
四、llm_wiki 的核心思路,不是“回答問題”,而是“建設知識體系”
這也是這個項目最讓我眼前一亮的地方。
今天很多 AI 知識庫的邏輯都是一樣的:
你上傳材料,然後提問,系統根據檢索結果給你答案。
這當然有用。
但它更像是一個“臨時答題器”。
• 你問一次,它組織一次。 • 你再問一次,它再組織一次。
它確實能回答問題,但它未必真的替你把知識沉澱下來。
而 llm_wiki 的思路不太一樣。
它不是把文檔當成一次次檢索的素材庫,
而是把文檔當成【“可以持續加工的知識原料”】。
AI 讀完這些內容之後,不只是給你一個答案,
而是嘗試把它們整理成:
• 有結構的頁面 • 可互相跳轉的連結 • 帶來源追蹤的內容 • 可以持續更新的知識圖譜 • 能反映整體認知狀態的 Wiki 系統
你可以把它理解成:
普通 AI 知識庫,是“你問,AI 回”。
而 llm_wiki 更像是“AI 先幫你把知識整理好,你再在這個結構上繼續思考”。
這兩種方式,看起來都在用 AI,
但底層邏輯完全不同。
• 前者強調即時響應,後者強調長期沉澱。 • 前者是問答工具,後者更接近知識建設工具。
五、為什麼“Wiki”這個方向,天然適合搭知識體系?
很多人會把 Wiki 理解成一種老派的文檔形式。
但如果你真的想搭知識體系,你會發現 Wiki 其實非常適合這件事。
因為 Wiki 有幾個天然優勢:
1. 它強調頁面之間的關係。
不是一篇篇孤立的筆記,而是一張可以不斷延伸的知識網絡。2. 它天然支持主題化組織。
一個概念、一位人物、一個方法論、一個項目,都可以成為獨立頁面,再彼此關聯。3. 它適合持續迭代。
知識體系不是一次寫完的,而是在不斷閲讀、理解、連接、修正中逐漸長出來的。4. 它更適合“從局部走向整體”。
你今天只整理一頁,明天再補兩頁,後天補一條連結,最後就可能長成一個完整的認知地圖。
所以從這個角度看,llm_wiki 的名字其實就已經說明了它的方向:
不是做一個會聊天的 AI,
而是做一個會幫你長 Wiki 的 AI。
這件事的價值在於,它讓“知識體系建設”從一件高門檻、重手工的事,慢慢變成一件可以被 AI 協助完成的事。
六、用 llm_wiki 創建知識體系,真正改變的是什麼?
如果只是“自動整理文檔”,那這個項目其實沒什麼特別。
但它真正改變的,是你和知識之間的工作關係。
以前的流程通常是這樣的:
1. 你收集資料。 2. 你手動看。 3. 你手動記。 4. 你手動分類。 5. 你手動建立聯繫。 6. 最後,你希望有一天這些內容能形成體系。
這套流程的問題不是不對,而是太重了。
它對執行力、耐心、長期維護能力的要求都很高。
很多人不是不會做,而是堅持不下來。
而 llm_wiki 提供的,是另一種可能:
你依然負責輸入材料、提出目標、做關鍵判斷;
但大量基礎性的整理、歸類、連結、生成概覽、維護結構,可以交給 AI 去完成。
這意味着,你可以把更多精力放在真正重要的事情上:
• 判斷哪些內容值得進入體系 • 決定這個體系服務什麼目標 • 審核 AI 建出來的結構是否合理 • 在關鍵節點加入你自己的理解和觀點
說得直接一點:
AI 不是替你思考,
而是把你從“知識搬運工”和“結構體力活”裏解放出來,讓你把精力用在更高層級的認知工作上。
這才是它對“知識體系建設”最現實的價值。
七、真正好的知識體系,不是“全”,而是“活”
很多人一說到知識管理,就容易陷入一個誤區:
總想把所有東西都收進去,總想一次搭成一個完美系統。
但知識體系從來不是靠“全收集”贏的,
而是靠【“持續生長”】贏的。
一個真正有生命力的知識體系,應該是這樣的:
• 它會隨着你的輸入不斷更新 • 它會隨着你的關注重點調整結構 • 它會把新材料和舊知識連接起來 • 它能讓你逐漸發現盲區、斷點和未完成的問題
從這個意義上說,知識體系不是書架,
更像花園。
• 書架是把東西擺上去。 • 花園是讓東西長起來。
而 llm_wiki 最有意思的地方,就是它明顯更接近 “花園型知識系統”。
你輸入文檔,它不是簡單堆着;
它會嘗試整理、連結、更新、擴展。
如果這個過程做得足夠穩定,它帶來的不只是“整理效率提升”,而是認知方式的變化。
你會慢慢從“我存了很多東西”,
轉向 “我真的有一套屬於自己的知識結構”。
八、如果你真的想搭自己的知識體系,可以從這一步開始
我覺得很多人看這類項目,容易有一個誤區:
以為要等工具完美了,自己才能開始。
其實不是。
真正重要的,不是你有沒有最強的工具,
而是你有沒有開始把“信息收集”升級成“知識組織”。
如果你想用 llm_wiki 來創建自己的知識體系,我反而建議從小處開始。
比如你可以先圍繞一個明確主題:
• AI 產品 • 個人寫作 • 投資研究 • 健康管理 • 某個長期項目 • 某個專業領域的學習路徑
先把相關資料集中起來,
然後讓系統幫你去生成初步的結構、頁面、關係連結和概覽。
接着你要做的,不是追求“一次成型”,
而是不斷地補充、修正、刪改、重連。
知識體系不是生成出來的,
而是在 “AI 協助 + 人工判斷” 的循環中長出來的。
這才是更現實,也更可持續的方式。
九、寫在最後
我們總以為,知識體系是一件很高級、很複雜、很費勁的事。
所以很多人一想到要“系統化整理”,就會本能拖延。
但本質上,知識體系不過是在回答一個問題:
你腦子裏的那些重要東西,能不能在外部世界也長出結構?
過去,這件事主要靠人自己一點點搭。
現在,像 llm_wiki 這樣的項目,給了我們一個新的可能:
也許 AI 不只是幫我們更快找到答案,
還可以幫我們更持續地建設認知本身。
這才是我覺得它真正值得關注的原因。
因為它解決的,不只是“怎麼問 AI”,
而是 “怎麼把你看到的、學到的、想到的東西,慢慢變成真正屬於你的知識體系”。
如果你手裏已經有很多資料、很多筆記、很多想法,卻一直沒有形成結構,
那也許可以試試從 llm_wiki 開始。
別再只是囤資料了。
去搭一個會生長的知識體系。