受夠了 AI 機械配音,我給 Codex 裝上了“我的聲音”!
整理版優先睇
將把聲放入 Codex:低頻用 MiniMax,長期自動化揀 Qwen3-TTS
大瑜係一個成日用 AI 工具整片嘅內容創作者,佢用 codex + hyperframe 自動將公眾號文章轉成影片:一篇文章寫完,系統就會生成影片同剪接,慳唔少時間。但 Hyperframe 內置嘅配音係機械腔,整到啲片冇咗個人特色,於是佢就想辦法將自己把聲放入個流程度。
佢試咗兩個方案。第一個係用 MiniMax 嘅線上 TTS,支持上傳音色,喺網頁輸入文字就出到音頻,每個月送 1000 積分,大概做到 10分鐘貨仔,好適合低頻用。第二個係自己裝 Qwen3-TTS,呢個開源模型嘅聲音克隆比較逼真,仲可以將你把聲儲起,日後隨時用。
整體結論好清楚:如果你只係間中整幾條片,MiniMax 夠方便;但你想長遠做自動化,尤其係配合 Codex 批量生成,就應該用 Qwen3-TTS,因為佢提供 API,可以直接畀 Codex 調用,實現『文章 → 配音 → 影片』全自動。大瑜自己都係揀咗呢條路,最後半個鐘就搞掂。
- 自動化生成影片雖然爽,但機械配音會即刻拉低質素,聲音克隆先可以保留個人特色。
- MiniMax 免費額度係月送 1000 積分,數到盡都係得 10幾分鐘,適合低頻使用。
- Qwen3-TTS 本地安裝可以複製你把聲,效果好逼真,仲可以保存聲線。
- 最關鍵係 Qwen3-TTS 有 API,畀 Codex 直接調用,先做到真正自動化而唔使人手下載。
- 成個方案大概花半個鐘設定,之後你嘅 AI 影片就可以一直用返你自己把聲。
MiniMax Text-to-Speech
線上 TTS 服務,支援上傳個人音色生成語音。每月有 1000 積分免費額度,適合低頻使用。
Qwen3-TTS (GitHub)
開源聲音克隆模型,可本地安裝並提供 API,方便整合到 Codex 自動化流程。
機械配音,係自動化影片嘅死穴
大瑜用開 codex + hyperframe,將公眾號文章自動變成影片。流程係『文章寫好 → 自動生成影片 → 自動剪接』,慳咗好多手腳。
成條流程最礙眼嘅位,就係 Hyperframe 內置嘅機械配音。
機械腔一嚟,就算內容幾有料,個人特色都即刻歸零。所以大瑜就試緊點樣將自己把聲放入個 pipeline。
記住呢個原則:低頻用 MiniMax,長期自動化用 Qwen3-TTS。
方案一:MiniMax 線上配音,快但額度有限
第一個方案係用 MiniMax 嘅線上 TTS 工具。你可以上傳個人音色,之後輸入文字,就即場下載音頻。
上傳音色呢一步最方便,唔使自己搞 server。
不過免費額度唔算多:每個月送 1000 積分。
- 1 分半鐘嘅影片大概用 800 積分。
- 換句話講,每個月 account 大概做到 10幾分鐘音頻。
如果只係間中整幾條片,呢個量都算夠用;但用得多就唔係好夠喉。
一句總結:MiniMax 適合低頻或者貪方便嗰陣用。
方案二:本地安裝 Qwen3-TTS,聲音克隆自己揸莊
第二個方案係自己安裝 Qwen3-TTS。呢個模型嘅聲音克隆效果好逼真,大瑜測試過都話得。
我需要一個 tts 的工具,幫我查詢地址git clone
https://github.com/QwenLM/Qwen3-TTS.git並安裝,啓動。
安裝步驟可以直接交畀 Codex 搞,唔使自己慢慢打 command。
裝好之後,使用步驟好簡單:
- 1 上傳你自己嘅音頻同對應文字。
- 2 輸入你要克隆嘅文字。
- 3 等合成完,就可以下載音頻。
呢個方案可以將你把聲保存低,下次直接 reuse。
仲有,Qwen3-TTS 提供 API,呢個先係佢最殺食嘅地方。
如果你唔怕麻煩,呢個先係長遠做自動化嘅根基。
用 API 接入 Codex,先至係真自動化
Qwen3-TTS 提供 API,即係話你可以喺 Codex 入面直接 call 佢。
一有 API,『文章 → 口播腳本 → 音頻』成條線就可以交畀 Codex 一條龍搞掂。
大瑜自己由零開始設定到成功出片,大約用咗半個鐘。之後每次只要文章寫好,Codex 就會自動搞掂配音部分。
唔使再喺 MiniMax 網頁同剪片軟件之間切來切去,效率高好多。
最近大瑜用 codex+hyperframe 將大瑜公眾號嘅內容自動變成影片。
文章寫完 → 自動生成影片 → 自動剪片。
但係有一個地方好頭痕:
Hyperframe 內置嘅配音,把聲好機械。
咁點樣先可以幫啲內容配上大瑜自己把聲呢?
兩個方法分享畀你,可以收藏定。
先講結論:
低頻****使用嘅話 → MiniMax
長期自動化嘅話 → Qwen3-TTS +API
一、用 minimax 內置嘅 tts 工具
網址:https://www.minimax.io/audio/text-to-speech
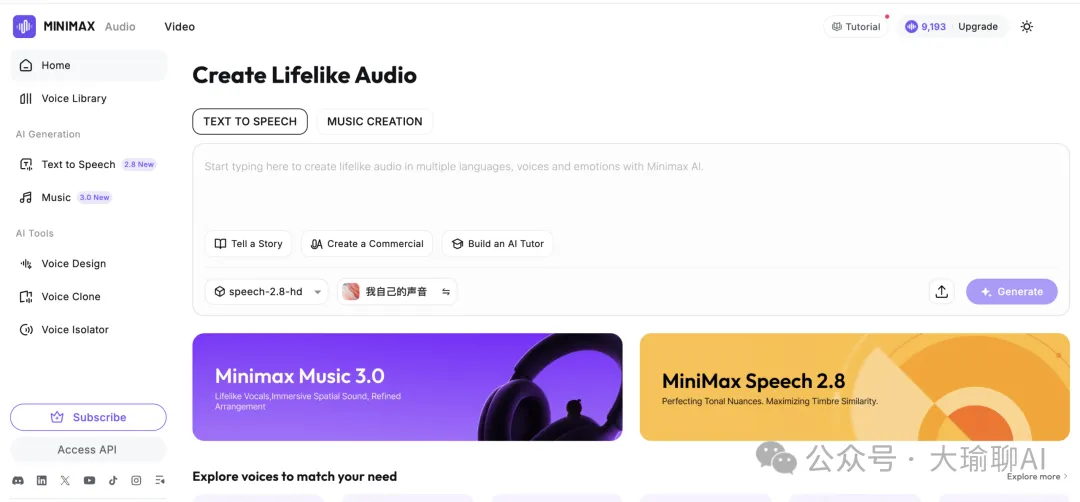
支援自己上載聲線,之後直接輸入文字,就可以快速下載音頻。
一個帳號,每個月送 1000 積分,一分半鐘嘅影片大概要消耗 800 積分。
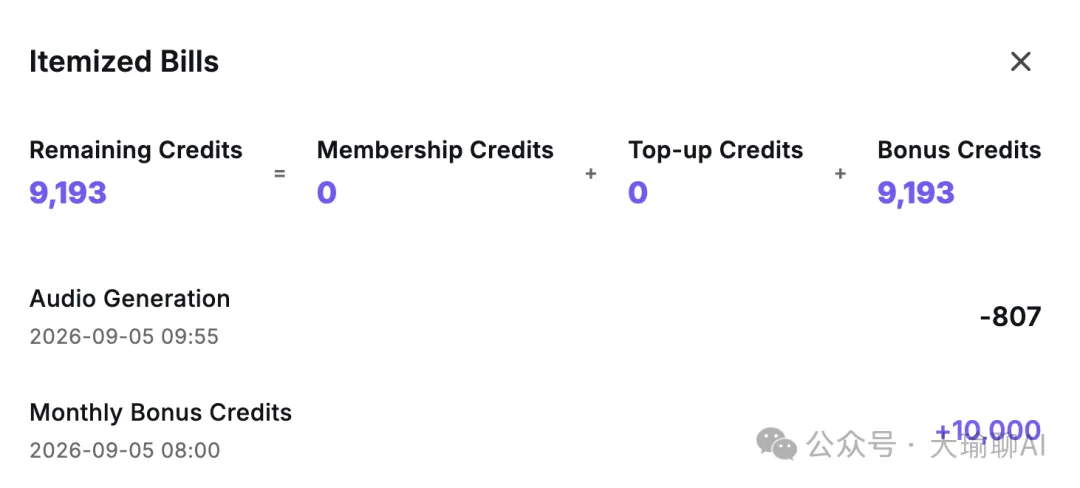
大概每個月每個帳號就可以生成十幾分鐘嘅音頻。
二、自己裝聲音克隆軟件
暫時 qwen3-tts 都幾好,聲音克隆嘅效果好逼真。
直接將呢句話發畀 codex,就得㗎喇。
我需要一個 tts 的工具,幫我查詢地址
git clone https://github.com/QwenLM/Qwen3-TTS.git
並安裝,啓動。
然後等一陣,你就會發現。
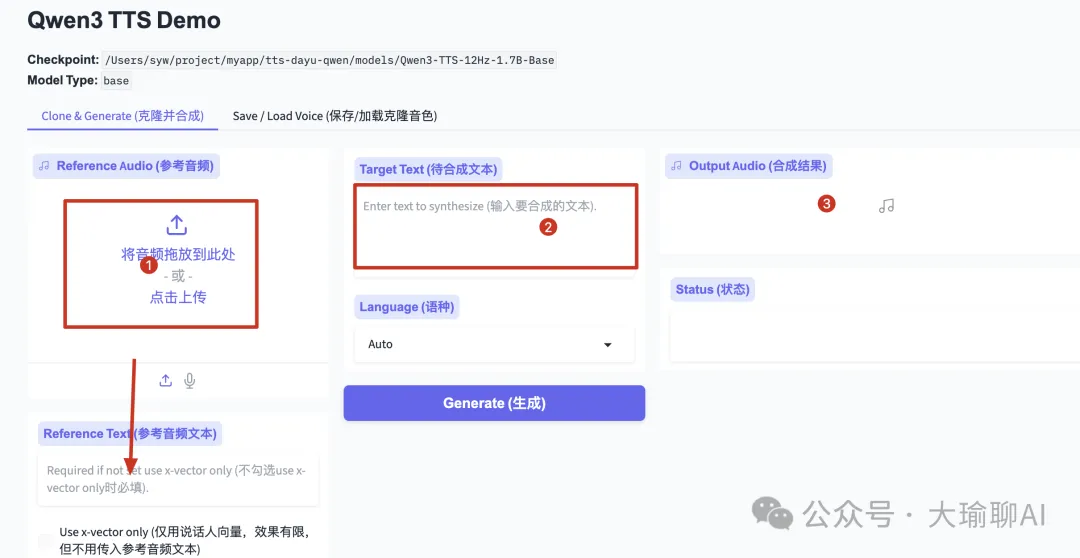
很方便
1、上載你自己嘅音頻同對應嘅文字
2、輸入你想克隆嘅文字
3、等最後合成。
當然,如果你覺得每次咁樣好麻煩,可以將你自己把聲儲低,下次直接用。
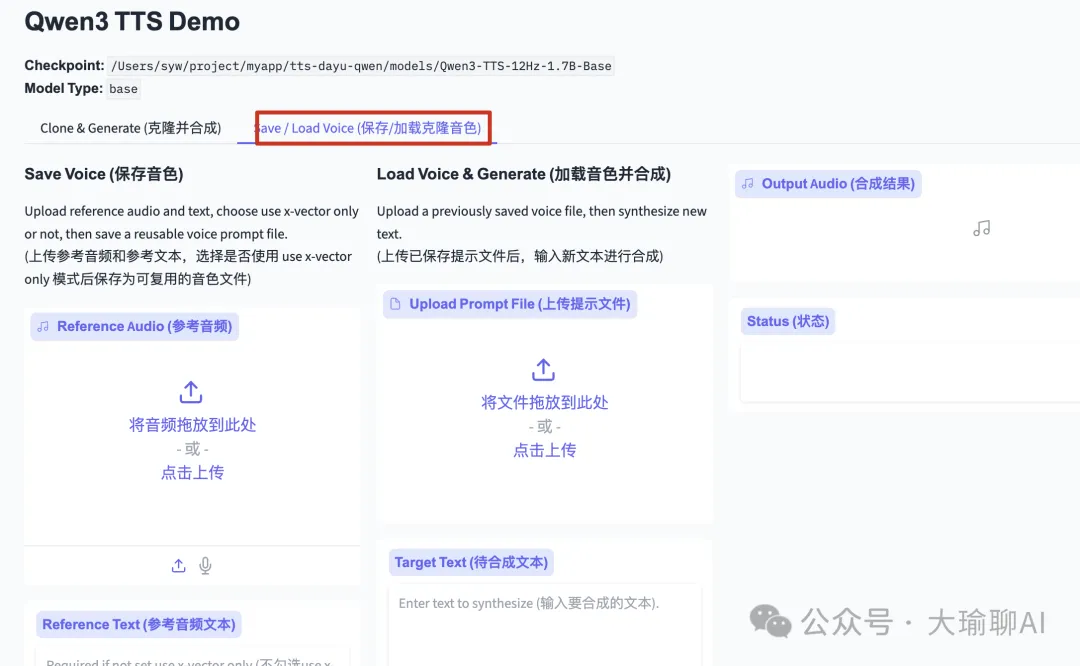
而且呢個本地方案嘅好處係:提供 API
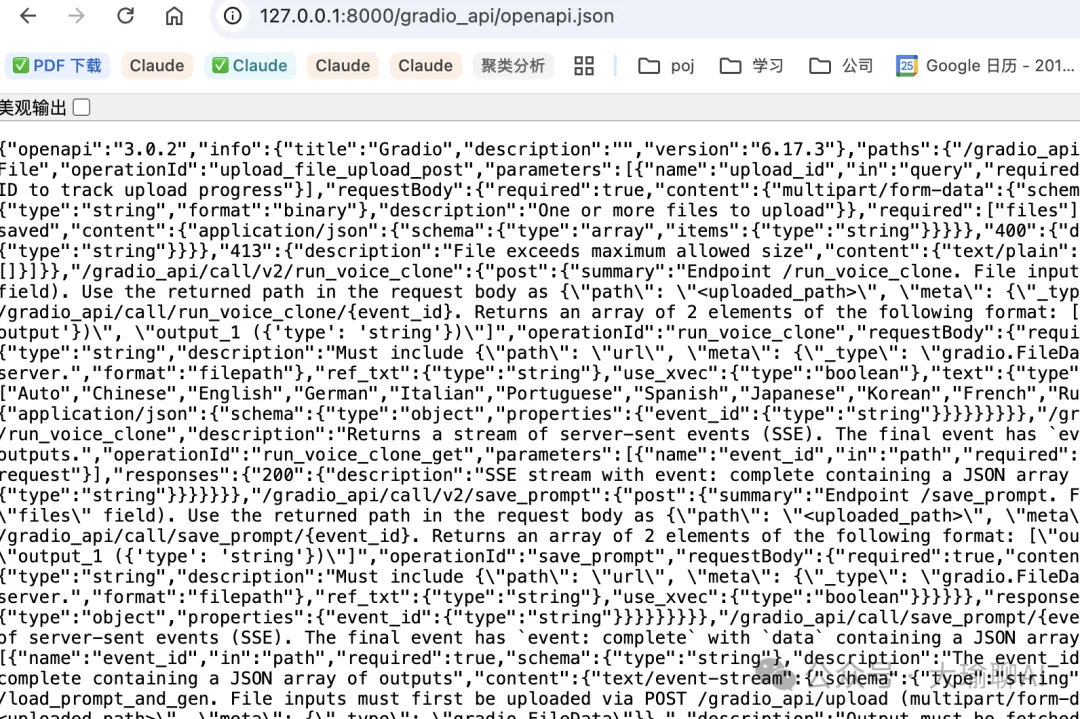
我哋用緊 codex 嘅時候,可以直接調用 API,快速根據旁白稿生成音頻。
咁樣就完全自動化曬啦!唔使喺唔同系統之間切換嚟切換去喇!
寫喺後面嘅話
今日搞咗半個鐘頭,終於合成咗呢條影片,大家覺得點?有興趣可以讚好同收藏。
我係大瑜,關注我,會分享更多關於 AI 編程同 Agent 嘅內容。
步驟:關注大瑜 -> 私訊大瑜 -> 認識大瑜。
最近大瑜用 codex+hyperframe 自動將大瑜公眾號內容轉化為視頻。
文章寫完 → 自動生成視頻 → 自動剪輯。
但是有一個地方很頭疼:
Hyperframe 自帶的配音,一股機械腔調。
那如何給文案配上大瑜自己的音頻呢?
兩種方案分享給你,可以收藏。
先說結論:
低頻****使用 → MiniMax
長期自動化 → Qwen3-TTS +API
一、用 minimax 自帶的tts 工具
網站:https://www.minimax.io/audio/text-to-speech
支持可以自己上傳音色,後續直接輸入文字,就能快速下載音頻。
一個賬號,1 個月贈送 1000 積分,1 分半的視頻差不多消耗 800 積分。
差不多 1 個月 1 個賬號可以生成 10 多分鐘的音頻。
二、自己安裝聲音克隆軟件
目前qwen3-tts 還是不錯,聲音克隆還是很逼真的。
直接把這句話發給 codex,即可。
我需要一個 tts 的工具,幫我查詢地址
git clone https://github.com/QwenLM/Qwen3-TTS.git
並安裝,啓動。
然後等待片刻,就會發現。
很方便
1、上傳你自己音頻和對應的文字
2、輸入你要克隆的文字
3、等待最終合成。
當然,如果你覺得每次麻煩,可以直接將你的聲音保存起來,下次直接用。
而且這個本地的好處 是:提供 API
我們在用 codex 中,直接調用 API 快速根據口播腳本,生成音頻。
這不是妥妥的自動化了嘛!也不用去各個系統去來回切換了嘛!
寫在後面的話
今天折騰了半個小時,最終合成了這樣的視頻,大家覺得如何,感興趣可以點贊收藏。
我是大瑜,關注我,分享更多 AI 編程和 Agent 相關的內容。
步驟:關注大瑜->私信->認識大瑜。