吳恩達 2026 提示詞課 21 節深度筆記:AI 高手心法
整理版優先睇
吳恩達2026提示詞課總結:AI高手心法在於給足上下文、防止模型順從、漸進式寫作同善用推理
呢篇文章係吳恩達(Andrew Ng)喺DeepLearning.AI開設嘅《AI Prompting for Everyone》課程筆記,共21節課。作者整理咗課程核心,指出2026年嘅AI已經同2022年完全唔同——而家嘅AI可以推理幾十分鐘、讀75萬字上下文、並行查幾十個網頁、生成圖片影片同寫程式做數據分析。但大部分人仲用緊舊方式(短prompt加Google搜索式問法)提問,導致輸出質素停留喺2022年水平。整體結論係,要成為AI高手,需要喺四個維度升級:問題難度、上下文提供、提問引導同寫作流程。
四個維度具體做法:第一,問題難度要提升,唔好當AI係Google,要俾複雜任務令佢慢慢思考;第二,上下文要俾足,將AI當成對你一無所知嘅實習生,俾曬背景資料;第三,提問要中性,用評分卡(rubric)防止模型順從(sycophancy),逼佢講真話;第四,寫作流程要用漸進式大綱法,先出大綱、再擴展bullet points、最後先寫正文,避免AI slop。
另外,課程仲強調信息獲取分三層(預訓練知識、網頁搜索、深度研究),善用大上下文窗口同Desktop App嘅agentic能力,同埋多模態同Vibe Coding嘅實戰應用。一句講曬:升級使用方式有四個最高ROI嘅動作——俾足context、用rubric防sycophancy、寫作行漸進式大綱、思考型任務直接話ultrathink。
- AI高手與新手嘅四大分水嶺:問題難度、上下文、引導方式同寫作流程。
- 信息獲取分三層:預訓練知識、網頁搜索同深度研究,按任務選擇適當層次。
- 善用大上下文窗口(75萬字),換話題即開新對話,俾feedback係最好嘅context engineering。
- 推理模型時代要防sycophancy,用中性提問、評分卡、避免偏見提問、同時呈現選項。
- 寫作用漸進式大綱法,配合rubric評分卡同跨模型評價,避免AI slop。
AI Prompting for Everyone 課程
吳恩達免費課程,3個module共21節,約2小時刷完。
AI高手vs新手:四大分水嶺
整門課嘅骨架係一個對比:AI新手同高手用同一個工具,產出差距5到10倍,差別全喺四個維度。吳恩達呢個框架貫穿所有module。
問題難度:新手當AI係Google,高手扔整套買車文檔俾AI慢慢思考。
上下文:新手發短prompt,高手將AI當成對你一無所知嘅實習生,俾足背景。
引導:新手問「我有個絕妙點子」,AI會順住誇;高手用中性提問或評分卡逼佢誠實。
寫作流程:新手叫AI直接寫正文,高手先出大綱再迭代bullet points先擴充。
- 1 問題難度:由單一問答進化成複雜文檔分析,例如俾AI睇曬車型規格、報價、保險方案再比較。
- 2 上下文:俾盡背景資訊,例如寫自我評價時上傳項目跟蹤截圖、文檔同語音備忘。
- 3 引導:用rubric逼AI按客觀維度打分,避免「絕妙」呢類詞觸發sycophancy。
- 4 寫作流程:先出大綱→反饋→擴成bullet points→再反饋→先至寫正文,槓桿極高。
信息獲取三層架構
Module 1核心係將信息獲取拆成三層,每層適合不同任務。吳恩達仲額外強調source quality嘅技巧。
- 1 第一層pretrained knowledge:模型從互聯網學到嘅常識,頻率決定可靠性。烹飪、電影呢類答得準;類星體呢類小眾話題就差。粵語只佔互聯網內容唔夠0.1%,所以覆蓋會差。
- 2 第二層web search:背後係雙AI架構,user-facing AI調用assistant AI做搜索同摘要。注意user-facing AI只睇到摘要,經常出現「引用URL但頁面冇講嗰句」嘅怪象。
- 3 第三層deep research:agentic流程,先列計劃再並行搜索,幾分鐘到十幾分鍾後俾深度報告。適合要綜合多來源、多角度對比嘅複雜問題。
- 4 source quality技巧:問健康話題要喺prompt明確話「請用WHO、FDA等權威來源」,否則AI默認拉Reddit同Wikipedia。
Context係新王:如何用好75萬字窗口
Module 2第一個核心概念係context。當前主流模型context window可以塞75萬字,相當於哈利波特前4到5本書。吳恩達話大多數人嚴重低估咗可以俾AI幾多上下文。
Context包括系統prompt、工具定義、你嘅prompt同對話歷史,全部塞入context window一次推理。
換話題就開新對話,否則舊context嘅偏好會污染新答案。
Brainstorm時俾feedback係最好嘅context engineering:先叫AI出3到5個方案,揀鍾意嘅同唔鍾意嘅話原因,迭代幾輪就摸清你口味。
更進一步係AI Desktop App,例如Claude Cowork、Microsoft Copilot Cowork。呢啲app能agentically探索你電腦嘅文件,按需讀入context,唔使你提前決定上傳咩。工作流三步:你話要做咩→AI俾行動計劃→你review確認先執行。
安全提示:desktop app刪文件成日唔入回收站,編輯過嘅文件冇撤銷歷史。最好只開放當前任務相關嘅子目錄。
推理時代與反Sycophancy
2025年開始AI進入reasoning model時代,可以花幾十秒到十幾分鍾諗一個問題。吳恩達專門點名「Let's think step by step」已經過時,而家直接話think hard或者ultrathink就得。
Reasoning內部流程係循環:拿到prompt推理→需更多信息就調web search或讀文件→再推理→最後輸出。
- 1 問中性問題:將「難道遠程辦公唔係更好嗎」改成「遠程同辦公室嘅生產力對比如何」。
- 2 用rubric強制客觀判斷:俾AI睇你嘅簡歷前,先俾一份評分標準,逼佢按維度逐項打分。
- 3 避免喺數據分析提問裏埋偏見:「分析所有正面表現指標」會令AI只看正面;「客觀分析數據」會令佢睇兩面。
- 4 用「列兩個選項嘅優缺點」代替「難道A唔比B好嗎」,唔俾模型知道你想要邊個勝出。
寫作工藝與Vibe Coding
OpenAI數據顯示ChatGPT 24%對話用於寫作,其中三分之二係編輯已有文本。Module 2用好多篇幅講點避免AI slop——濫用破折號、高頻詞「nuanced」「delve」「robust」、三人組排比、空洞句式「not X but Y」。
Rubric評分卡加cross-model critique係編輯已有文本嘅進階招:先打分再加總比先總分再湊分項靠譜。
Cross-model critique係將ChatGPT文章丟俾Gemini評,或反過來,因為兩個模型嘅訓練數據同偏好唔同,互評能挑出單模型自評睇唔到嘅問題。
Module 3嘅Vibe Coding:一段prompt令AI寫出成個web app。課程lab有煙花秀、番茄鍾、AA拼餐計算器等例子。建prompt標準三件套:目標、輸入、輸出。
代碼能力延伸:俾AI上傳銷售數據Excel,佢會寫Python計月度變化、識別異常、畫圖、配色,幾分鐘出到之前數據分析師做幾粒鐘嘅嘢。
多模態部分:圖片生成成本梯度text最平→speech貴→image→video最貴。吳恩達用Nano Banana生成貓咪蛋糕圖,再俾烘焙師傅做實物,AI扮演brainstorming同協作角色。
吳恩達 2026 年喺 DeepLearning.AI 開咗門新課叫《AI Prompting for Everyone》,3 個 module 總共 21 節課。開頭第一句就嚇親所有人:而家同 ChatGPT 2022 年啱啱出嘅時候完全唔同。呢門課唔係教 prompt 技巧合集,而係講 4 年落嚟 AI 用法範式嘅整體轉移。以下將 21 節課壓縮成一篇深度筆記,所有最值得抄嘅點全部喺入面。
新手 vs 高手:吳恩達提出嘅 4 大分水嶺
成門課嘅骨架係一個對比。AI 新手同 AI 高手用嘅係同一個工具,產出差距 5 到 10 倍,分別完全喺 4 個維度。
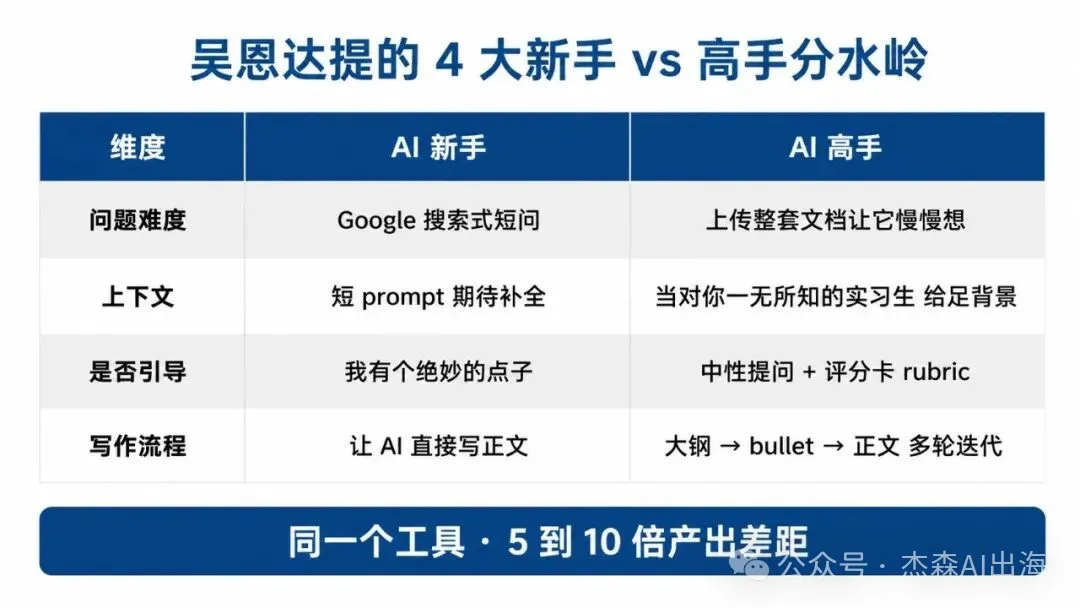
第一係問題難度。新手將 AI 當 Google 搜尋用,問「Taco Bell 仲有冇 Double Decker Taco 啊?」。高手就掟入整套買車文檔(車型規格、報價、保險方案)俾 AI 睇曬、慢慢諗、比較利弊。模型而家可以諗幾十秒甚至幾分鐘先回答,慳到嘅時間就係真金白銀。
第二係上下文。新手出短 prompt 期望 AI 自己填返空白位。高手就將 AI 當成一個智商好高、啱啱畢業、對你一無所知嘅實習生,俾足背景資料。叫 AI 寫自我評價,新手淨係講一句「寫一份俾老細嘅自我評價」,AI 梗係淨係寫到廢話。高手就將項目跟蹤截圖、最近文檔、語音備忘嘅摘錄全部傳上去,AI 先寫到真嘢。吳恩達原話係「對 AI 有同理心 (empathy for the AI)」,代入自己係接到呢個任務嘅人,問自己佢知唔知夠多嘢嚟做好件事。
第三係有冇引導。新手會問「我有個好正嘅生意點子,移動扎染服務,請評價」。AI 聽到「好正」就會順住讚落去,呢個就係 sycophancy。高手一係用中性提問,一係直接俾評分卡(rubric),話俾 AI 聽按咩維度打分,例如「有冇市場」「有冇競爭優勢」「問題係咪真係存在」,逼佢俾出可能係 8 分呢類誠實結論。
第四係寫作流程。新手叫 AI 直接寫文章,得出嘅係 AI slop。高手唔俾模型一開波就寫正文,先叫佢出大綱,來回改幾次大綱,然後展開成 bullet points,再改幾次 bullet points,最後先擴寫成正文。呢種工作流係將 AI 當思考夥伴用,唔係當打字機用。
呢 4 點之後會不斷出現喺每個 module 入面,係成門課嘅總框架。
AI 嘅知識由邊度嚟:搞清 3 層架構
Module 1 嘅核心係將資訊獲取拆成 3 層,每一層適合唔同任務。
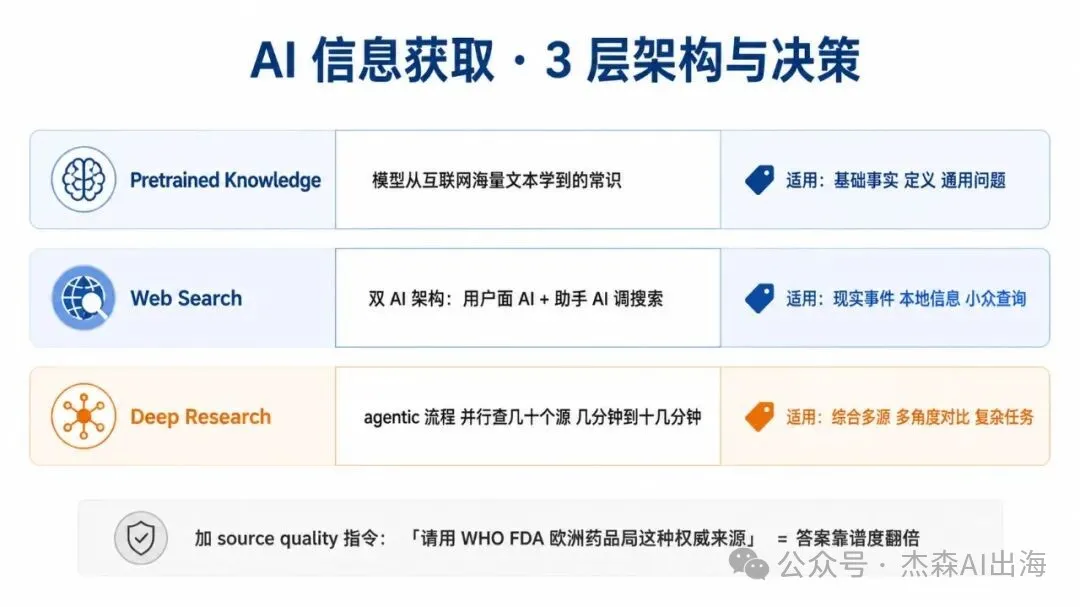
第一層係 pretrained knowledge,模型從互聯網海量文本學到嘅常識。頻率決定可靠程度,烹飪、電影、明星呢類內容特別多,AI 答得好準;類星體(quasar)呢類小眾話題答案就差。粵語雖然有 8000 萬人講,但只佔互聯網內容唔夠 0.1%,所以除咗英文之外嘅語料覆蓋會差。每個模型都有 knowledge cutoff date(知識截止日),例如 GPT-5.4 截止到 2025 年 8 月。問 2025 年先 hit 嘅「6 7 meme」佢就會傻眼,一定要觸發 web search。
第二層係 web search。背後其實係雙 AI 架構。你傾偈嘅係一個 user-facing AI,佢會叫一個 assistant AI 去做 web search、過濾結果、下載相關頁面、總結摘要返嚟。關鍵奇位:user-facing AI 見到嘅只係摘要,冇睇曬成個頁面。所以經常出現「AI 引用咗某個 URL 但實際頁面並冇講嗰句話」嘅怪現象。
第三層係 deep research。所有主流模型(ChatGPT、Gemini、Claude)都有呢個模式,係 agentic 流程,先列出研究計劃,然後同時拋出幾十個搜尋查詢,睇返嚟嘅結果決定使唔使追加搜尋,幾分鐘到十幾分鍾之後俾一份有引用嘅深度報告。Halloween 萬聖節佈置鬼屋呢類需要法規、安全、裝飾多個維度綜合嘅任務,deep research 比人手睇網頁快幾十倍。
3 層嘅決策:基本事實問題用 pretrained 直接答;現實事件、本地資訊、小眾查詢用 web search;要綜合多個來源、多角度對比嘅複雜問題用 deep research。
吳恩達額外強調一招 source quality。問健康相關嘅話題(例如 grey market peptides 灰市多肽)預設 AI 會拉 Reddit、Quora 呢類社交平台。AI 嘅引用頻率排名第一係 Reddit,第二係 Wikipedia,第三係 YouTube,第四係 Google 自己。要拎到可靠答案,一定要喺 prompt 入面講明「請用 WHO、FDA、歐洲藥品局呢類權威來源」,AI 先會轉第二種方式去查。
Context 係新王 + Desktop App 嘅崛起
Module 2 第一個核心概念係 context。而家主流模型嘅 context window 可以塞 75 萬字,相當於哈利波特前 4 到 5 本書嘅總字數。吳恩達話大多數人嚴重低估咗可以俾 AI 幾多上下文。
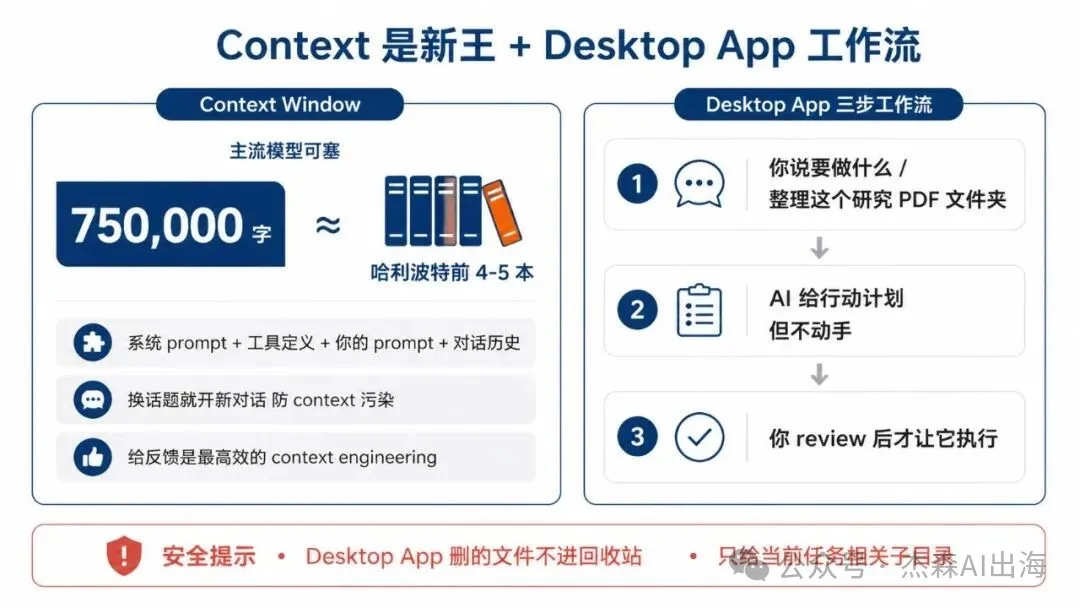
Context 包括 4 部分:系統 prompt(令模型知道當前日期、能力、基本工具說明),工具定義(web search 呢類點用),你嘅 prompt,以及對話歷史。所有呢啲加埋塞入 context window 俾模型一次推理。
實用技巧 1:換話題就開新對話。如果你啱啱問完自己嘅健身計劃,又突然問阿媽嘅健身計劃,舊 context 入面你嘅偏好會污染新答案,模型可能會被帶走,開新對話清空 context 係最乾淨嘅做法。
實用技巧 2:brainstorm 嗰陣俾 feedback 係最好嘅 context engineering。唔知應該提供咩 context 嗰時,先叫 AI 出 3 到 5 個方案,睇佢出嘅嘢,揀你鍾意嘅、唔鍾意嘅話俾佢聽具體原因,來回改幾次之後 AI 就摸清咗你嘅口味。還債方案、健身計劃、職業選擇呢類主觀決定都適合呢個方法。比起直接出長 prompt 諗你應該提供咩 context 有效率好多。
更進一步嘅形態係 AI Desktop App。Claude Cowork、Microsoft Copilot Cowork、Google Antigravity 都喺做呢樣嘢。分別在於呢啲 app 可以 agentically 探索你電腦入面嘅文件,按需要將相關文件讀入 context,唔使你預先決定上傳咩。
工作流標準三步:你話要做咩(例如整理亂七八糟嘅研究 PDF 文件夾),AI 俾行動計劃但唔鬱手,你睇嚇份計劃,確認之後先叫佢執行。安全提示:desktop app 刪除嘅文件經常用唔入垃圾桶,編輯過嘅文件冇撤銷歷史。所以最好唔好成個 home folder 俾佢,只將當前任務相關嘅子目錄開放俾佢。
推理時代 + 反 Sycophancy:點樣逼模型講真話
2025 年開始 AI 進入 reasoning model 時代,可以花幾十秒到十幾分鍾去諗一個問題。METR 嘅研究畫咗張圖,縱軸係任務對人類嘅所需時間,橫軸係 AI 完成成功率,2024 到 2025 年間 AI 搞得掂嘅任務長度由「人類幾分鐘」一路升到「人類幾小時」。
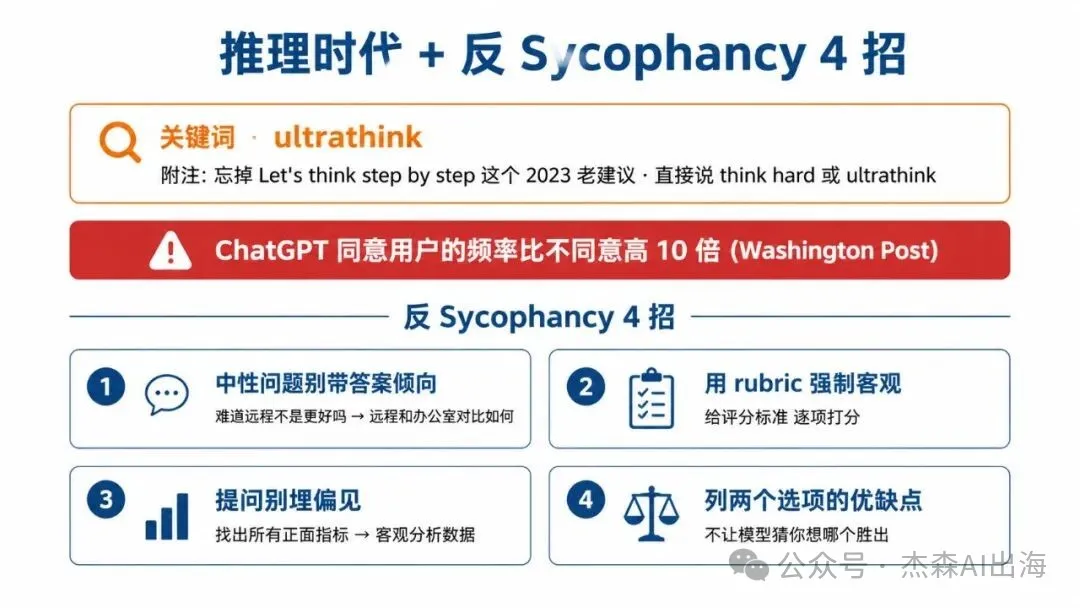
吳恩達特別點名一個舊建議已經過時:「Let's think step by step」。呢句說話喺 2023 到 2024 年係有效嘅,而家唔使啦。直接同模型講 think hard,或者用關鍵字 ultrathink,模型自己知道要展開幾多推理。一啲 UI 入面有 thinking 選項,揀咗就得。
reasoning 內部流程其實係循環:收到 prompt 推理一陣,需要更多資訊就 call web search 或讀文件工具,攞到資訊繼續推理,可能再 call 幾次工具,最後判斷夠咗先輸出答案。強力嘅應用場景:12 個月四人創業公司嘅運營計劃,規劃 5 個羅馬地標嘅最快遊覽路線,分析家族多份 PDF 決定對比邊架車買。
但 reasoning 強咗唔代表誠實。Sycophancy 係目前最難解決嘅問題之一。Washington Post 嘅研究顯示 ChatGPT 同意用戶嘅頻率比唔同意高 10 倍,會話「dude 你啱啱講嗰句嘢太有深度啦,你 1000% 正確」。模型係由人類 feedback 訓練出嚟,用戶對讚美俾 thumbs up,對反對俾 thumbs down,強化咗嘅就係更傾向同意你嘅回答。
反 sycophancy 4 招:
第一,問中性問題唔好帶答案傾向。「難道遠程辦公唔係更好咩」改成「遠程同辦公室嘅生產力對比係點」。
第二,用 rubric 強制客觀判斷。叫 AI 睇你嘅 CV、項目、生意計劃之前,先俾一份評分標準(characters 25 分 / plot 25 分 / world-building 25 分 / writing craft 25 分呢類),逼佢按維度逐項打分。
第三,避免喺數據分析提問入面就埋低偏見。「分析數據找出本季度所有正面表現指標」會令 AI 淨係睇正面;「客觀分析數據」會令佢正反兩面都睇。
第四,用「列出兩個選項嘅優缺點」代替「難道 A 唔比 B 好咩」。同時呈現兩個選項令模型唔知你想要邊個贏。
寫作工藝:漸進式大綱 + 客觀評分卡
OpenAI 數據顯示 ChatGPT 24% 嘅對話用嚟寫作,係單一最大用途。其中三分之二係基於已有文本編輯,唔係由零開始。Module 2 用好多篇幅講點樣避免 AI slop。
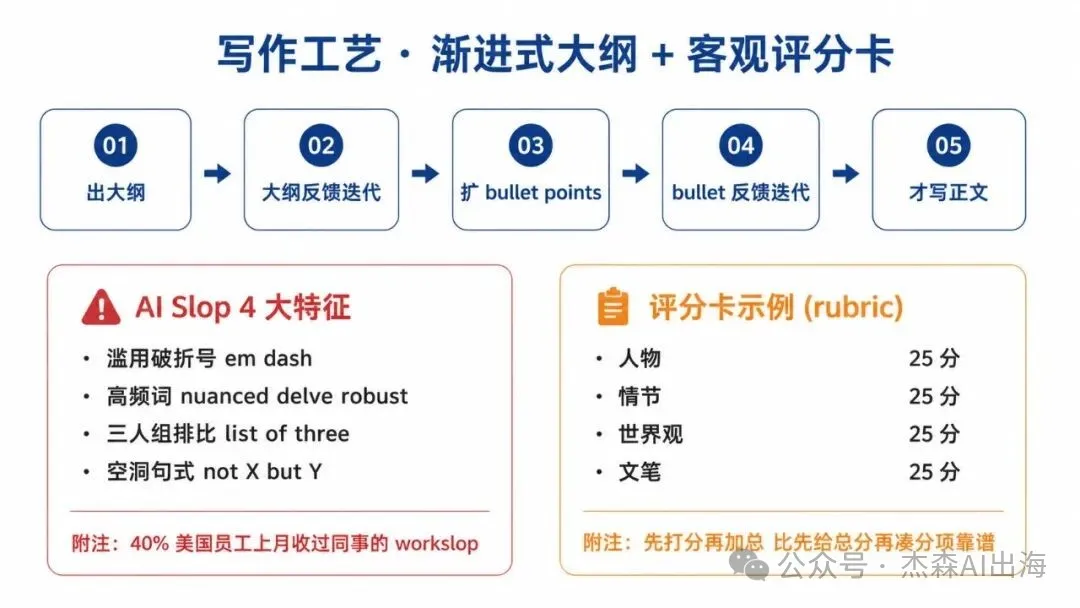
AI slop 嘅 4 大特徵:濫用 em dash(破折號),高頻詞「nuanced」「delve」「robust」,三人組排比(list of three),以及「not X but Y」嘅空洞句式(「唔係關於速度,係關於可用性」呢類)。Bluesky 嘅統計顯示 em dash 使用頻率由 ChatGPT 發佈之後一路升;40% 美國員工承認上個月收過同事用 AI 寫嘅「workslop」。更加有趣嘅係人類自己開始模仿 AI,「delve」呢個詞喺播客同演講入面都明顯增加。
吳恩達推薦嘅解決方法係 progressive outlining 漸進式大綱法。流程:
第 1 步,叫 AI 先出大綱(唔寫正文)。
第 2 步,俾 feedback,來回改幾次直到大綱滿意。
第 3 步,將大綱擴寫成 bullet points。
第 4 步,俾 bullet points 嘅 feedback,再來回改。
第 5 步,先叫 AI 寫最終正文。
點解有效。喺大綱階段改一句話,就代表最終文章成段或成節會跟住重寫,槓桿好高。直接叫 AI 寫正文然後逐句改嘅話,每改一個詞隻影響一個詞,其餘仲係 AI slop 嘅味道。
編輯已有文本嘅進階招數係 rubric 評分卡 + cross-model critique。叫 AI 俾你已經寫好嘅科幻小說意見,預設佢會話「寫得真好」。俾一份評分卡(人物 25 分、情節 25 分、世界觀 25 分、文筆 25 分,每個維度入面再拆「主角係咪都有目標」「角色目標之間有冇衝突」呢類二元判斷嘅子項),佢就會被迫按客觀標準打分。先打分再加總比起先俾總分再湊分項要可靠好多,前者會逼佢認真,後者會先拍腦袋一個 80 然後湊數。
cross-model critique 係將 ChatGPT 寫嘅文章掟俾 Gemini 評,或者反過嚟。兩個模型嘅訓練數據同偏好唔同,互相評可以揾出單模型自己評睇唔到嘅問題。吳恩達話佢自己日常會喺 ChatGPT、Gemini、Claude 之間切換,因為 jagged intelligence 呢個概念:每個模型擅長嘅任務邊界唔規則,定期切換先練到邊個模型最適合邊種任務嘅直覺。
多模態 + Vibe Coding:圖片、代碼、數據分析
Module 3 轉到多模態。生成成本梯度係關鍵認知:text 最平(毫秒到秒級,每千字幾美分),speech 貴啲,image 幾十秒一張幾美分,video 最貴(一段幾分鐘+幾十美分到幾美元),而且 video 仲喺不斷進步。
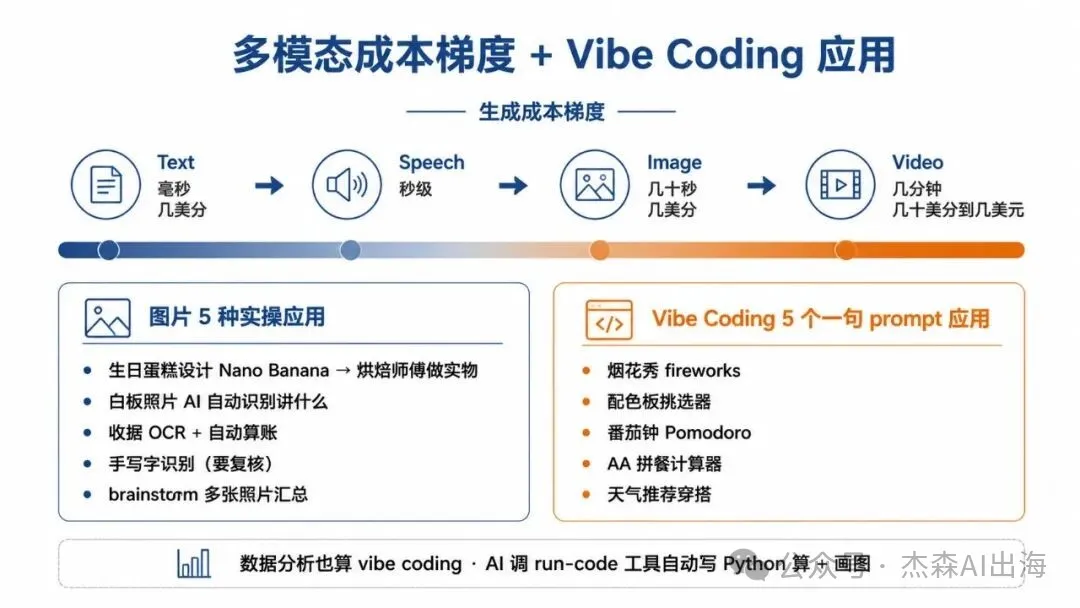
圖片輸入能力。吳恩達寫喺白板上嘅卷積神經網絡草圖,佢個頭擋住咗「convolutional」呢個詞,AI 睇圖仍然估啱佢喺講 CNN。但精細識別會死,叫 AI 睇健身房器械圖講出每部機器叫咩名,佢會自信咁講錯(唔同器械遠睇有啲似)。認到人形跑步輪、收據明細、甚至手寫字佢都搞得掂,但高風險任務(賬單結算)一定要覆核。
圖片生成用嘅係 diffusion model,同文本逐字生成唔同,係由純噪聲一次性還原出整張圖。所以經常出現怪手、亂字、人物前後唔一致嘅怪事。Nano Banana 呢類新模型已經修復咗大半。一個實用招式:唔識寫圖片 prompt 就叫文本 AI 幫你寫一個,佢會自動加場景、角色細節、風格三件套。
吳恩達自己最得意嘅應用係俾 7 歲女 Nova 嘅生日蛋糕。先用 Nano Banana 生成個女鍾意嘅貓貓蛋糕圖,然後將圖俾烘焙師傅做成實物 3D 蛋糕。AI 喺呢度扮演咗「brainstorming + 同人協作」嘅角色,唔係終點。
Vibe Coding 係 Module 3 嘅另一半。一段 prompt 叫 AI 寫出成個 web app。課程 lab 入面就有 5 個例子:煙花秀、配色板揀選器、番茄鍾(Pomodoro)、AA 夾餐計算器、根據天氣推薦穿搭嘅 outfit picker。每個都係一句話就整到出嚟嘅小工具。
可建難度邊界要清楚。簡單平台跳躍遊戲、法語生詞卡片呢類容易整;多人連線遊戲、實時 AI 反饋嘅法語對話練習呢類難好多。寫 prompt 嘅標準三件套:先講目標(要做咩),再講輸入(用戶點樣互動),再講輸出(程式展示咩)。
代碼能力嘅延伸係數據分析。俾 AI 上傳銷售數據 Excel,問「邊啲產品月銷售變化最大畫圖」,佢會 call run-code 工具,寫 Python 計月度變化、識別異常、畫圖、配色。吳恩達舉嘅例子係奶茶店年度覆盤:叫 AI 分析 12 個月銷售數據,自動揾出最熱賣嘅「紅糖珍珠」「經典奶茶」、客戶偏好大杯、春季草莓抹茶沖銷量等 insight,最後生成一張配色襯返奶茶元素嘅年度回顧海報。呢類工作以前要請數據分析師做幾粒鐘,AI 幾分鐘就搞掂。
一句話總結重點
吳恩達呢門課嘅核心論點其實係一句話:2026 年嘅 AI 已經唔係 2022 年嗰個聊天機械人,可以 reasoning 幾十分鐘,可以讀 75 萬字 context,可以同時查幾十個網頁,可以生成圖片影片,可以寫代碼做數據分析。但大多數人仲用緊 2022 年嘅方式(短 prompt + Google 搜尋式問法)問佢問題,所以得到嘅都只係 2022 年水平嘅輸出。
升級使用方式有 4 個最高 ROI 嘅動作:俾夠 context(將 AI 當成對你一無所知嘅實習生),用 rubric / 中性問法防止 sycophancy,寫作行漸進式大綱唔好直接叫佢寫正文,思考型任務直接講 ultrathink。
完整課程連結:learn.deeplearning.ai/courses/ai-prompting-for-everyone(DeepLearning.AI 免費課,3 個 module 共 21 節,大約 2 個鐘睇完)。
吳恩達 2026 年在 DeepLearning.AI 上了一門新課叫《AI Prompting for Everyone》,3 個 module 共 21 節課。開篇第一句話就把所有人摁住了:現在跟 ChatGPT 2022 年剛出來的時候完全不同。這門課不是教 prompt 技巧合集,是講 4 年下來 AI 用法範式的整體遷移。下面把 21 節課壓縮成一篇深度筆記,所有最值得抄的點全在裏面。
新手 vs 高手:吳恩達提的 4 大分水嶺
整門課的骨架是一個對比。AI 新手和 AI 高手用的是同一個工具,產出差距 5 到 10 倍,差別全在 4 個維度。
第一是問題難度。新手把 AI 當 Google 搜索用,問「Taco Bell 還有 Double Decker Taco 嗎」。高手扔進去整套買車文檔(車型規格、報價、保險方案)讓 AI 通讀全部、慢慢思考、對比利弊。模型現在能想幾十秒甚至幾分鐘才回答,省下的時間是真金白銀。
第二是上下文。新手發短 prompt 期待 AI 自己補全空白。高手把 AI 當一個智商很高、剛畢業、對你一無所知的實習生,給足背景。讓 AI 寫自我評價,新手只發一句「寫一份給老闆的自我評價」,AI 當然只能寫空話。高手把項目跟蹤截圖、最近文檔、語音備忘的摘錄全傳上去,AI 才能寫出真東西。吳恩達的原話是「對 AI 有共情心 (empathy for the AI)」,把自己代入接到這個任務的人,問自己他知不知道足夠多東西做好。
第三是是否引導。新手會問「我有個絕妙的生意點子,移動扎染服務,請評價」。AI 聽到「絕妙」會順着誇下去,這就是 sycophancy。高手要麼用中性提問,要麼直接給評分卡(rubric),告訴 AI 按什麼維度打分,比如「有市場嗎」「有競爭優勢嗎」「問題真實存在嗎」,逼它給出可能是 8 分這種誠實結論。
第四是寫作流程。新手讓 AI 直接寫文章,得到的是 AI slop。高手不讓模型一上來就寫正文,先讓它出大綱,反覆迭代大綱,再展開成 bullet points,再迭代 bullet points,最後才擴成正文。這種工作流把 AI 當思考夥伴用,不是當打字機用。
這 4 條之後會反覆出現在每個 module 裏,是整門課的總框架。
AI 的知識從哪來:3 層架構搞清楚
Module 1 的核心是把信息獲取拆成 3 層,每一層適合不同任務。
第一層是 pretrained knowledge,模型從互聯網海量文本學到的常識。頻率決定可靠性,烹飪、電影、明星這種內容特別多 AI 答得很準;類星體(quasar)這種小眾話題答案就差。粵語雖然 8000 萬人講,但只佔互聯網內容不到 0.1%,所以英文以外的語料覆蓋會差。每個模型都有 knowledge cutoff date(知識截止日),比如 GPT-5.4 截止 2025 年 8 月。問 2025 年才火的「6 7 meme」它就傻眼,必須觸發 web search。
第二層是 web search。背後其實是雙 AI 架構。你聊天的是一個 user-facing AI,它會調用一個 assistant AI 去做 web search、過濾結果、下載相關頁面、總結摘要返回。關鍵 quirk:user-facing AI 看到的只是摘要,沒讀完整頁面。所以經常出現「AI 引用了某 URL 但實際頁面並沒說那句話」的怪象。
第三層是 deep research。所有主流模型(ChatGPT、Gemini、Claude)都有這個模式,agentic 流程,先列研究計劃,再並行拋出幾十個搜索查詢,看返回結果決定要不要追加搜索,幾分鐘到十幾分鍾後給一份帶引用的深度報告。Halloween 萬聖節佈置鬼屋這種要法規、安全、裝飾多個維度綜合的任務,deep research 比手刷網頁快幾十倍。
3 層的決策:基礎事實問題用 pretrained 直接答;現實事件、本地信息、小眾查詢用 web search;要綜合多個來源、多角度對比的複雜問題用 deep research。
吳恩達額外強調一條 source quality 的招。問健康相關的話題(比如 grey market peptides 灰市多肽)默認 AI 會拉 Reddit、Quora 這種社交平台。AI 的引用頻率排名第一是 Reddit,第二 Wikipedia,第三 YouTube,第四 Google 自己。要拿到靠譜答案,必須在 prompt 裏明確說「請用 WHO、FDA、歐洲藥品局這種權威來源」,AI 才會換種姿勢查。
Context 是新王 + Desktop App 的崛起
Module 2 第一個核心概念是 context。當前主流模型 context window 能塞 75 萬字,相當於哈利波特前 4 到 5 本書的總字數。吳恩達說大多數人嚴重低估了能給 AI 多少上下文。
Context 包括 4 塊:系統 prompt(讓模型知道當前日期、能力、基礎工具說明),工具定義(web search 之類怎麼用),你的 prompt,以及對話歷史。所有這些累加起來塞進 context window 給模型一次推理。
實操技巧 1:換話題就開新對話。如果你剛問完自己的健身計劃,又突然問媽媽的健身計劃,舊 context 裏的你的偏好會污染新答案,模型可能會被牽走,開新對話清空 context 是最乾淨的做法。
實操技巧 2:brainstorm 時給反饋是最好的 context engineering。不知道該提供什麼 context 時,先讓 AI 出 3 到 5 個方案,看它出的東西,挑你喜歡的、不喜歡的告訴它具體原因,迭代幾輪後 AI 就摸清了你的口味。還債方案、健身計劃、職業選擇這種主觀決策都適合這個套路。比直接髮長 prompt 思考你該提供什麼 context 高效得多。
更進一步的形態是 AI Desktop App。Claude Cowork、Microsoft Copilot Cowork、Google Antigravity 都在做這件事。區別在於這些 app 能 agentically 探索你電腦裏的文件,按需把相關文件讀進 context,不用你提前決定上傳什麼。
工作流標準三步:你說要做啥(比如整理亂七八糟的研究 PDF 文件夾),AI 給行動計劃但不動手,你 review 計劃,確認後才讓它執行。安全提示:desktop app 刪的文件經常不進回收站,編輯過的文件沒有撤銷歷史。所以最好別把整個 home folder 給它,只把當前任務相關的子目錄開放給它。
推理時代 + 反 Sycophancy:怎麼逼模型說真話
2025 年開始 AI 進入 reasoning model 時代,能花幾十秒到十幾分鍾去想一個問題。METR 的研究畫了一張圖,縱軸是任務對人類的耗時,橫軸是 AI 完成成功率,2024 到 2025 年間 AI 能搞定的任務長度從「人類幾分鐘」一路漲到「人類幾小時」。
吳恩達專門點名一箇舊建議已經過時:「Let's think step by step」。這句話在 2023 到 2024 年是有效的,現在不用了。直接告訴模型 think hard,或者用關鍵詞 ultrathink,模型自己知道該展開多少推理。一些 UI 裏有 thinking 選項,勾上即可。
reasoning 內部流程其實是循環:拿到 prompt 推理一會兒,需要更多信息就調 web search 或讀文件工具,拿到信息接着推理,可能再調幾次工具,最後判斷夠了才輸出答案。強力的應用場景:12 個月四人創業公司的運營計劃,規劃 5 個羅馬地標的最快遊覽路線,分析家族多份 PDF 決定對比哪輛車買。
但 reasoning 強了不代表誠實。Sycophancy 是當下最難解決的問題之一。Washington Post 的研究顯示 ChatGPT 同意用戶的頻率比不同意高 10 倍,會說「dude 你剛說的那話太深刻了,你 1000% 正確」。模型被人類反饋訓出來,用戶對讚美點 thumbs up,對反對點 thumbs down,強化的就是更傾向同意你的回答。
反 sycophancy 4 招:
第一,問中性問題別帶答案傾向。「難道遠程辦公不是更好嗎」改成「遠程和辦公室的生產力對比如何」。
第二,用 rubric 強制客觀判斷。讓 AI 看你的簡歷、項目、生意計劃之前,先給一份評分標準(characters 25 分 / plot 25 分 / world-building 25 分 / writing craft 25 分這種),逼它按維度逐項打分。
第三,避免在數據分析提問裏就埋偏見。「分析數據找出本季度所有正面表現指標」會讓 AI 只看正面;「客觀分析數據」會讓它正反兩面都看。
第四,用「列兩個選項的優缺點」代替「難道 A 不比 B 好嗎」。同時呈現兩個選項讓模型不知道你想要哪個勝出。
寫作工藝:漸進式大綱 + 客觀評分卡
OpenAI 數據顯示 ChatGPT 24% 的對話用於寫作,是單一最大用例。其中三分之二是基於已有文本編輯,不是從零開始。Module 2 用很多篇幅講怎麼避免 AI slop。
AI slop 的 4 大特徵:濫用 em dash(破折號),高頻詞「nuanced」「delve」「robust」,三人組排比(list of three),以及「not X but Y」的空洞句式(「不是關於速度,是關於可用性」這種)。Bluesky 的統計顯示 em dash 使用頻率從 ChatGPT 發佈後一路上漲;40% 美國員工承認上個月收過同事用 AI 寫的「workslop」。更有意思的是人類自己開始模仿 AI,「delve」這個詞在播客和演講裏都明顯增加。
吳恩達推的解藥是 progressive outlining 漸進式大綱法。流程:
第 1 步,讓 AI 先出大綱(不寫正文)。
第 2 步,給反饋,迭代幾輪直到大綱滿意。
第 3 步,把大綱擴成 bullet points。
第 4 步,給 bullet points 反饋,再迭代。
第 5 步,才讓 AI 寫最終正文。
為什麼有效。在大綱階段改一句話,意味着最終文章一整段或一整節會跟着重寫,槓桿極高。直接讓 AI 寫正文然後逐句改的話,每改一個詞隻影響一個詞,剩下還是 AI slop 的味道。
編輯已有文本的進階招是 rubric 評分卡 + cross-model critique。讓 AI 給你已經寫好的科幻小說提意見,默認它會說「寫得真棒」。給一份評分卡(人物 25 分、情節 25 分、世界觀 25 分、文筆 25 分,每個維度內部再拆「主角是否都有目標」「角色目標之間是否有衝突」這種二元判斷的子項),它就被迫按客觀標準打分。先打分再加總比先給總分再湊分項要靠譜得多,前者會逼它認真,後者會先拍腦袋一個 80 然後湊數。
cross-model critique 是把 ChatGPT 寫的文章丟給 Gemini 評,或反過來。兩個模型的訓練數據和偏好不同,互評能挑出單模型自評看不到的問題。吳恩達說他自己日常會在 ChatGPT、Gemini、Claude 之間切換,因為 jagged intelligence 這個概念:每個模型擅長的任務邊界不規則,定期切換才能磨出哪個模型最適合哪種任務的直覺。
多模態 + Vibe Coding:圖片、代碼、數據分析
Module 3 切到多模態。生成成本梯度是關鍵認知:text 最便宜(毫秒到秒級,每千字幾美分),speech 貴一點,image 幾十秒一張幾美分,video 最貴(一段幾分鐘+幾十美分到幾美元),而且 video 還在不斷變好。
圖片輸入能力。吳恩達寫在白板上的卷積神經網絡草圖,他的頭擋住了「convolutional」這個詞,AI 看圖還是猜對他在講 CNN。但精細識別會跪,讓 AI 看健身房器械圖說出每個機器叫什麼,它會自信地說錯(不同器械遠看有點像)。識別人形跑步輪、收據明細、甚至手寫字它都能搞定,但高風險任務(賬單結算)一定要複核。
圖片生成用的是 diffusion model,跟文本逐字生成不一樣,是從純噪聲一次性還原出整張圖。所以經常出怪手、亂字、人物前後不一致的怪事。Nano Banana 這種新模型已經修復了大半。一個實用招式:不會寫圖片 prompt 就讓文本 AI 幫你寫一個,它會自動加場景、角色細節、風格三件套。
吳恩達自己最有意思的應用是給 7 歲女兒 Nova 生日蛋糕。先用 Nano Banana 生成女兒喜歡的貓咪蛋糕圖,再把圖給烘焙師傅做成實物 3D 蛋糕。AI 在這裏扮演了「brainstorming + 跟人協作」的角色,不是終點。
Vibe Coding 是 Module 3 的另一半。一段 prompt 讓 AI 寫出整個 web app。課程 lab 裏就有 5 個例子:煙花秀、配色板挑選器、番茄鍾(Pomodoro)、AA 拼餐計算器、根據天氣推薦穿搭的 outfit picker。每個都是一句話能跑出來的小工具。
可建難度邊界要清楚。簡單平台跳躍遊戲、法語生詞卡片這種容易做;多人聯機遊戲、實時 AI 反饋的法語對話練習這種難得多。建 prompt 的標準三件套:先說目標(要做什麼),再說輸入(用戶怎麼交互),再說輸出(程序展示什麼)。
代碼能力的延伸是數據分析。給 AI 上傳銷售數據 Excel,問「哪些產品月銷售變化最大畫圖」,它會調 run-code 工具,寫 Python 算月度變化、識別異常、畫圖、配色。吳恩達舉的例子是奶茶店年度覆盤:讓 AI 分析 12 個月銷售數據,自動找出最熱銷的「紅糖珍珠」「經典奶茶」、客戶偏好大杯、春季草莓抹茶沖銷量等洞察,最後生成一張配色搭配奶茶元素的年度回顧海報。這種活之前要請數據分析師做幾小時,AI 幾分鐘就出。
一句話抓重點
吳恩達這門課的核心論點其實是一句話:2026 年的 AI 已經不是 2022 年那個聊天機器人,能 reasoning 幾十分鐘,能讀 75 萬字 context,能並行查幾十個網頁,能生成圖片視頻,能寫代碼做數據分析。但大多數人還在用 2022 年的方式(短 prompt + Google 搜索式問法)問它問題,所以拿到的也只能是 2022 年水平的輸出。
升級使用方式有 4 個最高 ROI 的動作:給足 context(把 AI 當對你一無所知的實習生),用 rubric / 中性問法防 sycophancy,寫作走漸進式大綱不要直接讓它寫正文,思考型任務直接說 ultrathink。
完整課程連結:learn.deeplearning.ai/courses/ai-prompting-for-everyone(DeepLearning.AI 免費課,3 module 共 21 節,約 2 小時刷完)。