把一本書編譯成可調用的 Skill,一週漲 3,957 stars
整理版優先睇
將一本書編譯成可調用嘅 Skill,慳返大量重複查資料嘅 token
呢篇文章介紹咗一個叫 book-to-skill 嘅開源項目,喺 GitHub 一週攞到 3,957 stars,累計 18,862 stars。佢唔淨止係將 PDF 轉做 Skill,而係將一本技術書(例如 244 頁)轉成一套結構化知識:SKILL.md、章節文件、術語表、模式庫同一張決策速查表。作者想解決嘅問題係:平時用 Agent 問書本問題,成日要將成本書塞入上下文,或者每次重新搜索目錄,好浪費 token 同時間。
呢個工具將轉換分成兩半:Python extractor 負責解析格式、清理文本、識別章節;Agent 就按 SKILL.md 規範生成章節、術語表、模式庫同決策表。咁樣拆分,程序做穩定嘢,模型做判斷。項目方用 Think Python 2 測試,成本書直接輸入要 119,264 token,用 book-to-skill 只要約 5,000 token,慳 24 倍——但呢個數字只係上下文比較,唔代表答案質素。
結論係:book-to-skill 最適合處理會反覆查閲嘅資料,例如團隊 ADR、runbook、RFC、設計規範、論文筆記。佢支援多文件輸入同 fold-in 更新。使用前要檢查提取模式、章節邊界、數據私隱、prompt injection 風險同版權。總括嚟講,佢將「長上下文」問題轉成「預先建立索引」問題,對重複查詢場景好有價值。
- book-to-skill 將一本書轉成 SKILL.md、章節文件、術語表、模式庫同一張決策速查表,核心係「遇到 X 時選擇 Y,因為 Z」嘅決策規則。
- 流程分兩半:Python extractor 負責穩定解析文件,Agent 負責理解結構並生成知識文件,程序同模型各司其職。
- 對比成本書直接輸入(119,264 token),book-to-skill 只需要約 5,000 token,慳 24 倍上下文;但呢個數字唔等於答案品質保證。
- 最適合用喺會反覆查閲嘅資料(團隊文檔、RFC、規範、筆記),唔係讀一次就完嘅 PDF;支援 fold-in 合併新文件。
- 實際使用前要檢查提取模式、章節邊界、數據私隱、prompt injection 同版權;可以喺 Claude Code、Amp、Copilot CLI 入面直接調用。
book-to-skill GitHub 專案
將書籍或文件集編譯成可畀 Agent 調用嘅 Skill,支援 PDF、EPUB、DOCX、HTML、Markdown 等多種格式。
Skill 生成規範
定義 SKILL.md、chapters、glossary、patterns、cheatsheet 嘅結構,特別係 cheatsheet 要寫成「遇到 X 時選擇 Y,因為 Z」。
性能數據
Think Python 2 例子顯示成本書直接輸入 vs book-to-skill 嘅 token 差距,同埋喺其他書上嘅完整區間。
一本書最後變成乜嘢?
Book-to-skill 嘅輸入可以係一份 PDF、一個文件目錄、glob,或者一組混合格式嘅檔案。當前支援 PDF、EPUB、DOCX、HTML、Markdown、純文字、RTF,仲可以透過 Calibre 處理 MOBI/AZW。
輸出唔係一份越嚟越長嘅摘要,而係一組有明確分工嘅知識文件
my-book/
├── SKILL.md
├── chapters/
│ ├── ch01-*.md
│ ├── ch02-*.md
│ └── ...
├── glossary.md
├── patterns.md
└── cheatsheet.md
呢幾個文件各自承擔唔同任務,令 Agent 可以按需讀取,而唔係背起成本書。
- SKILL.md:保存核心框架、章節索引同主題索引,係 Agent 嘅起點。
- chapters/*.md:每章嘅概念、方法、例子同反模式,按需讀取。
- glossary.md:按字母排列嘅術語,並標註來源章節。
- patterns.md:彙總書入面嘅技術、算法同設計模式。
- cheatsheet.md:整理決策規則、權衡表、閾值同問題徵兆。
呢個先係一本書進入工作流之後嘅實質變化
先由程式拆解,再交畀 Agent 重組
Book-to-skill 冇將所有步驟都交畀模型,而係拆成兩半:確定性嘅 Python extractor 加上 Agent 分析重組。
PDF / EPUB / DOCX / Markdown / HTML
 ↓
確定性的 Python extractor
 ↓
full_text.txt + metadata.json
 ↓
Agent 按 SKILL.md 規範分析結構
 ↓
核心 Skill + 章節 + 術語 + 模式 + 決策表
Extractor 負責展開輸入、選擇解析器、清理文本、識別章節,並寫成帶來源邊界嘅 full_text.txt 同 metadata.json。Agent 就按 SKILL.md 嘅十步規範,生成每章文件、主題索引、術語表同速查表。
文件解析、格式降級同章節檢測更適合交畀程序
邊啲內容算框架、邊啲應該入決策表,更適合交畀模型判斷
程序負責穩定,Agent 負責理解同重組
唔止一本書:文件集都搞得掂
個名雖然有 book,但用法文檔話你知可以一次過輸入多份文件,仲支援 fold-in 合併。
適合處理團隊 ADR、runbook、入職文檔、架構說明、RFC、API 合約、品牌語氣、設計原則
- 團隊內部文檔:ADR、runbook、入職手冊、架構說明。
- 技術規範:RFC、API 合約、合規文件。
- 品牌與設計:語氣指南、設計原則、組件規範。
- 研究材料:相關論文、個人閲讀筆記、後續新增資料。
Fold-in 功能令新文件可以併入已有 Skill,更新章節、索引、術語表同速查表,啱曬不斷變化嘅內部文檔。
例如可以將 Codex 倉庫嘅 README、AGENTS.md 同官方指南整理成一個資料集合
實際使用前,要檢查提取模式(pdftotext 快但冇表格,Docling 慢但保留結構)、章節邊界、數據私隱、prompt injection 風險同版權。
生成 Skill 之前要先確認提取模式同結構質素
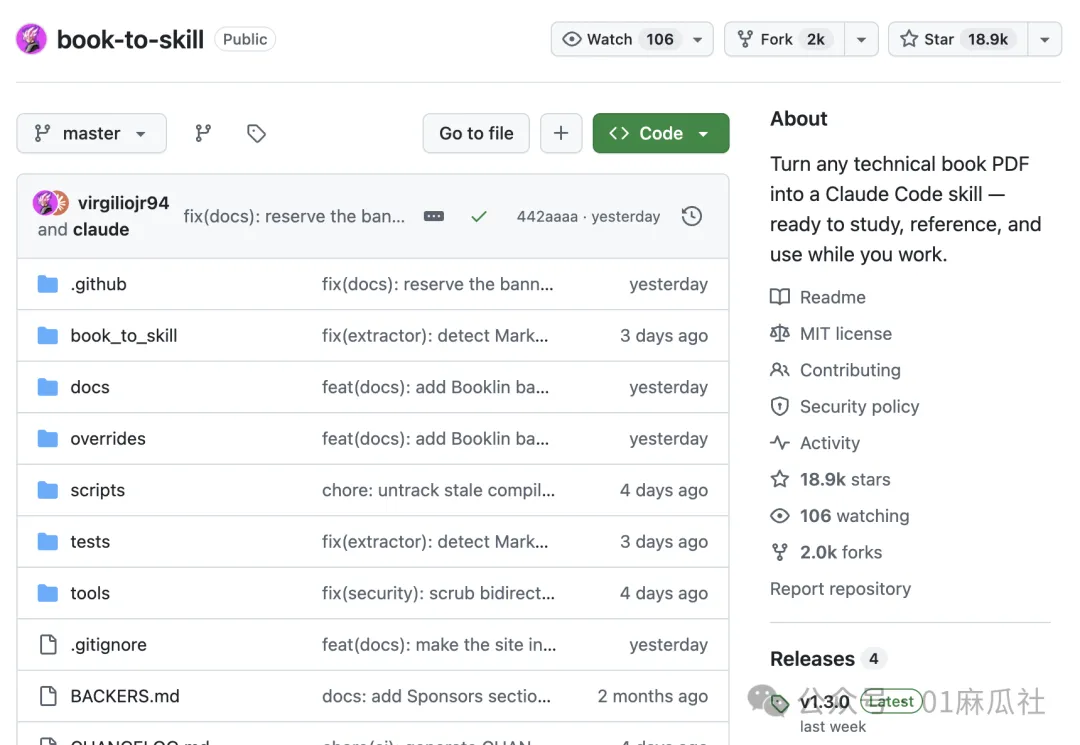
book-to-skill 喺 GitHub Trending 嘅周榜卡片度攞到 今個星期 3,957 stars,累計已經去到 18,862 stars。
真正吸引我嘅並唔係『PDF 轉 Skill』呢句介紹,而係佢交付嘅嘢:一本 244 頁嘅技術書,最後會變成 SKILL.md、按章節分開嘅文件、術語表、模式庫同一張決策速查表。下次再問書入面嘅問題,Agent 唔使重新讀完整本書,只需要載入核心索引同相關章節。
換句話講,佢想做嘅唔係更快咁總結一本書,而係將翻查資料嘅成本,提早編譯成一套可以長期調用嘅知識結構。
我哋嚟拆解下佢係點樣做,同埋邊啲資料適合咁樣處理。希望對大家有幫助。
一本書最後變成啲乜
跟住項目嘅 README[1],輸入可以係一份 PDF,亦都可以係一個文檔目錄、glob,或者一組唔同格式嘅文件。目前支援 PDF、EPUB、DOCX、HTML、Markdown、純文字、RTF,以及透過 Calibre 處理嘅 MOBI/AZW。
轉換完成之後,得到嘅唔係一個越嚟越長嘅摘要文件,而係下面呢套目錄:
my-book/
├── SKILL.md
├── chapters/
│   ├── ch01-*.md
│   ├── ch02-*.md
│   └── ...
├── glossary.md
├── patterns.md
└── cheatsheet.md
呢啲文件各自負責唔同任務:
| 文件 | 實際用途 |
|---|---|
SKILL.md | 保存核心框架、章節索引同主題索引 |
chapters/*.md | 保存每一章嘅概念、方法、例子同反模式,按需要讀取 |
glossary.md | 按字母排序整理術語,並標明來源章節 |
patterns.md | 整合書入面嘅技術、算法同設計模式 |
cheatsheet.md | 整理決策規則、取捨表、閾值同問題徵兆 |
呢度最緊要嘅係 cheatsheet.md。項目嘅 Skill 生成規範[2]明確要求佢唔可以只係另一份術語表,而係要將作者嘅判斷寫成『遇到 X 時選擇 Y,因為 Z』。
咁先係一本書進入工作流程之後嘅實質變化。你唔再淨係可以問『呢一章講咗啲乜』,仲可以問『我而家遇到呢個條件,跟住書入面嘅方法應該點揀』。
佢先提取,再俾 Agent 組織知識
book-to-skill 冇將所有步驟都交曬俾模型。佢將轉換分成兩半:
PDF / EPUB / DOCX / Markdown / HTML
                 ↓
確定性的 Python extractor
                 ↓
full_text.txt + metadata.json
                 ↓
Agent 按 SKILL.md 規範分析結構
                 ↓
核心 Skill + 章節 + 術語 + 模式 + 決策表
前半係確定性嘅 Python 提取器。佢負責展開多份輸入、選擇解析器、清理文字、識別章節,並將結果寫成帶來源邊界嘅 full_text.txt 同統計資訊 metadata.json。架構文檔[3]將呢一層叫做 extractor。
後半先至係 Agent。佢跟住倉庫入面嘅 SKILL.md 分析書名、作者、目錄同主題,再生成每一章嘅文件、主題索引、術語表同速查表。呢一層唔係固定模型寫死嘅生成器,而係一份有成十個步驟嘅執行規範。
呢種拆法解決咗兩個問題。
首先,文件解析、格式降級同章節檢測更加適合交俾程序處理。PDF 係純文字定係包含代碼同表格,都會影響提取器嘅選擇:文字型 PDF 優先行 pdftotext 等快速路徑;技術型 PDF 可以用 Docling 保留 Markdown 表格同代碼塊。
其次,邊啲內容算框架、邊啲應該入決策表、唔同章節點樣建立聯繫,更加適合俾模型判斷。程序負責將材料處理得穩定,Agent 負責理解同重組。
真正慳到嘅係重複導航
平時要 Agent 回答一本書入面嘅問題,常見做法有兩種。
一種係將成本書塞曬入上下文。優點係材料齊曬,代價係每次對話都要重新負擔一大段輸入。
另一種係臨時搜索目錄、定位章節、讀取內容。佢比全文輸入慳,但 Agent 每次仍然要重新行一遍『揾目錄 - 估章節 - 讀取 - 回退』嘅過程。
book-to-skill 呢個項目嘅思路係將導航工作預先做好:SKILL.md 常駐核心框架同主題索引,具體章節留喺獨立文件入面。問到某個主題時,Agent 再順住索引讀取對應章節。
項目的 性能數據[4]用 Think Python 2 做咗一個例子:
| 路徑 | 回答一個目標問題時進入上下文嘅 token |
|---|---|
| 成本書直接輸入 | 119,264 |
| 項目模擬嘅臨時發現流程 | 12,152 |
book-to-skill 核心 + 一個章節 | 大約 5,000 |
對應嘅差距係 24 倍同 2.4 倍。項目喺另外兩本書上給出嘅完整區間係 24 - 51 倍,但呢度必須講清楚:呢啲係項目方用 tiktoken 同佢哋自己嘅 discovery model 得到嘅上下文 token 對比,唔係獨立重現嘅答案質量 benchmark。
佢冇證明生成之後嘅 Skill 一定答得更準,亦都冇將首次轉換所需嘅模型調用、時間同費用消除。佢證明嘅係另一件更窄、亦都更可信嘅事:當同一批資料會被反覆查詢時,預先建立索引同章節文件,可以減少日後重複搬運同定位材料嘅開銷。
唔單止係將書變成筆記
項目個名雖然有 book,但 用法文檔[5]支援一次輸入多份文件:
/book-to-skill ~/papers/paper1.pdf ~/notes/export.txt unified-research
/book-to-skill ~/workspace/project-docs/ project-knowledge
/book-to-skill "~/books/*.epub" my-library
呢個令佢更加適合處理幾類成日俾人重新打開嘅資料:
- 團隊嘅 ADR、runbook、入職文件同架構說明。
- 一組 RFC、API 合約或合規規範。
- 品牌語氣、設計原則同組件規範。
- 相關論文、自己嘅閲讀筆記同後續新增材料。
佢仲支援 fold-in:將新文件合併入已有嘅 Skill,更新章節、主題索引、術語表同速查表。對於不斷變化嘅內部文檔,呢個比每次重新生成成套內容更加實際。
例如,我可以將 Codex 倉庫嘅 README.md、根目錄 AGENTS.md再加埋官方 Prompting、AGENTS.md 同 Skills 指南整理成一個資料集合。
呢個例子都說明咗佢最適合嘅材料:唔係讀一次就完,而係你會持續查閲、反覆應用,並且希望答案保留來源結構嘅內容。
先將快速路徑跑通
項目目前明確支援 GitHub Copilot CLI、Amp 同 Claude Code。以 Claude Code 為例,可以將倉庫安裝到 Skill 目錄:
git clone https://github.com/virgiliojr94/book-to-skill.git \
  ~/.claude/skills/book-to-skill
處理技術書之前,先檢查本機可用嘅提取器:
python3 ~/.claude/skills/book-to-skill/scripts/extract.py --check
然後喺 Agent 入面調用:
/book-to-skill ~/Documents/thinkpython2.pdf think-python-2
流程會先問資料係技術型定文字型,再顯示來源數量、頁數、預計 token、生成文件同成本估算。確認之後先繼續生成。完成之後可以按主題或章節調用:
/think-python-2 word frequency analysis
/think-python-2 ch13
/think-python-2 "what chapters do you have?"
第一次體驗,我會揀一本章節標題清楚、自己有權處理嘅公開技術書。咁樣最容易檢查章節識別、代碼塊保留同主題索引係咪正確。
生成 Skill 之前先檢查呢幾件事
呢類工具最容易製造一個錯覺:文件生成齊全,就等於知識已經可靠。實際上,轉換後嘅 Skill 仍然需要抽查。
第一,確認提取模式。項目自己嘅測試入面,一份 103 頁技術 PDF 使用 pdftotext 只用咗 0.1 秒,但冇保留表格同代碼塊;Docling 用咗 164 秒,保留咗 48 張表格同 36 個代碼塊。速度同結構質素唔可以同時假設係最好。
第二,檢查章節邊界同主題索引。冇明確 Chapter N、多欄排版或標題格式特殊嘅書,可能識別失敗,需要手動指定章節。
第三,唔好將本地提取等同於數據唔會離開部機器。安全說明[6]寫明提取器本身唔會上傳文件,但如果 Agent 背後嘅模型係喺雲端運行,送俾模型嘅文本仍然受對應服務嘅數據條款約束。
第四,檢查文檔入面嘅惡意指令。7 月 30 日發佈嘅 v1.3.0[7]加入咗不可見 Unicode 清理、DOCX XML 防護同生成 Skill 嘅 prompt injection 掃描。呢啲改動說明維護者正在處理真實嘅 document-to-context 供應鏈風險,但掃描器被項目明確標為 advisory,唔可以代替人工審閲。
第五,核對版權。轉換器用 MIT 協議,唔代表輸入嘅書都可以重新發布。自己買嘅書可以當做個人學習資料處理,生成後嘅 Skill 可唔可以分享,仍然取決於原始內容嘅許可。
book-to-skill 呢個星期嘅增長有一個好清楚嘅原因:佢冇繼續承諾『更長上下文可以裝到更多資料』,而係將問題換成『點樣令 Agent 下次只讀真正需要嘅部分』。
對於只查一次嘅 PDF,轉換成套 Skill 可能冇必要。對於一本會反覆引用嘅技術書,或者一組每日都要遵守嘅團隊文檔,先將結構整理好,下一次提問先至真正開始慳時間。
- 項目倉庫:https://github.com/virgiliojr94/book-to-skill[1]
References
- README: https://github.com/virgiliojr94/book-to-skill
- Skill 生成規範: https://github.com/virgiliojr94/book-to-skill/blob/master/SKILL.md
- 架構文檔: https://github.com/virgiliojr94/book-to-skill/blob/master/docs/architecture.md
- 性能數據: https://github.com/virgiliojr94/book-to-skill/blob/master/docs/performance.md
- 用法文檔: https://github.com/virgiliojr94/book-to-skill/blob/master/docs/usage.md
- 安全說明: https://github.com/virgiliojr94/book-to-skill/blob/master/SECURITY.md
- v1.3.0: https://github.com/virgiliojr94/book-to-skill/releases/tag/v1.3.0
book-to-skill 在 GitHub Trending 的周榜卡片上拿到 3,957 stars this week,累計已經達到 18,862 stars。
真正抓住我的並不是“PDF 轉 Skill”這句介紹,而是它交付的東西:一本 244 頁的技術書,最後會變成 SKILL.md、按章文件、術語表、模式庫和一張決策速查表。下次再問書裏的問題,Agent 不需要重新讀完整本書,只加載核心索引和相關章節。
換句話說,它想做的不是更快地總結一本書,而是把反覆查資料的成本,提前編譯成一套可以長期調用的知識結構。
我們來拆解一下它是怎麼做的,以及什麼資料適合這樣處理。期望對大家有所幫助。
一本書最後變成什麼
按照項目的 README[1],輸入可以是一份 PDF,也可以是一個文檔目錄、glob,或者一組不同格式的文件。當前支持 PDF、EPUB、DOCX、HTML、Markdown、純文本、RTF,以及通過 Calibre 處理的 MOBI/AZW。
轉換完成後,得到的不是一個越來越長的摘要文件,而是下面這套目錄:
my-book/
├── SKILL.md
├── chapters/
│   ├── ch01-*.md
│   ├── ch02-*.md
│   └── ...
├── glossary.md
├── patterns.md
└── cheatsheet.md
這些文件各自承擔不同任務:
| 文件 | 實際用途 |
|---|---|
SKILL.md | 保存核心框架、章節索引和主題索引 |
chapters/*.md | 保存每章的概念、方法、例子和反模式,按需讀取 |
glossary.md | 按字母整理術語,並標註來源章節 |
patterns.md | 彙總書裏的技術、算法和設計模式 |
cheatsheet.md | 整理決策規則、權衡表、閾值和問題徵兆 |
這裏最關鍵的是 cheatsheet.md。項目的 Skill 生成規範[2]明確要求它不能只是另一份術語表,而要把作者的判斷寫成“遇到 X 時選擇 Y,因為 Z”。
這才是一本書進入工作流後的實質變化。你不再只能問“這一章講了什麼”,還可以問“我現在遇到這個條件,按照書裏的方法應該怎麼選”。
它先提取,再讓 Agent 組織知識
book-to-skill 沒有把所有步驟都交給模型。它把轉換分成了兩半:
PDF / EPUB / DOCX / Markdown / HTML
                 ↓
確定性的 Python extractor
                 ↓
full_text.txt + metadata.json
                 ↓
Agent 按 SKILL.md 規範分析結構
                 ↓
核心 Skill + 章節 + 術語 + 模式 + 決策表
第一半是確定性的 Python 提取器。它負責展開多份輸入、選擇解析器、清理文本、識別章節,並把結果寫成帶來源邊界的 full_text.txt 和統計信息 metadata.json。架構文檔[3]把這一層稱為 extractor。
第二半才是 Agent。它按照倉庫裏的 SKILL.md 分析書名、作者、目錄和主題,再生成每章文件、主題索引、術語表和速查表。這一層不是固定模型寫死的生成器,而是一份長達十個步驟的執行規範。
這種拆法解決了兩個問題。
首先,文件解析、格式降級和章節檢測更適合交給程序。PDF 是純文字還是包含代碼和表格,也會影響提取器選擇:文字型 PDF 優先走 pdftotext 等快速路徑;技術型 PDF 可以使用 Docling 保留 Markdown 表格和代碼塊。
其次,哪些內容算框架、哪些應該進入決策表、不同章節怎麼建立聯繫,更適合讓模型判斷。程序負責把材料處理得穩定,Agent 負責理解和重組。
真正省下的是重複導航
平時讓 Agent 回答一本書裏的問題,常見做法有兩種。
一種是把整本書塞進上下文。優點是材料都在,代價是每次會話都要重新承擔大段輸入。
另一種是臨時搜索目錄、定位章節、讀取內容。它比全文輸入節省,但 Agent 每次仍要重新走一遍“找目錄 - 猜章節 - 讀取 - 回退”的過程。
book-to-skill 的思路是把導航工作預先做完:SKILL.md 常駐核心框架和主題索引,具體章節留在獨立文件裏。問到某個主題時,Agent 再順着索引讀取對應章節。
項目的 性能數據[4]用 Think Python 2 做了一個例子:
| 路徑 | 回答一個目標問題時進入上下文的 token |
|---|---|
| 整本書直接輸入 | 119,264 |
| 項目建模的臨時發現流程 | 12,152 |
book-to-skill 核心 + 一個章節 | 約 5,000 |
對應的差異是 24 倍和 2.4 倍。項目在另外兩本書上給出的完整區間是 24 - 51 倍,但這裏必須說清楚:這些是項目方用 tiktoken 和自己的 discovery model 得到的上下文 token 對比,不是獨立復現的答案質量 benchmark。
它沒有證明生成後的 Skill 一定答得更準,也沒有把首次轉換所需的模型調用、時間和費用消除。它證明的是另一件更窄、也更可信的事:當同一批資料會被反覆查詢時,預先建立索引和章節文件,可以減少以後重複搬運與定位材料的開銷。
不只是把書變成筆記
項目名字裏雖然有 book,但 用法文檔[5]支持一次輸入多份文件:
/book-to-skill ~/papers/paper1.pdf ~/notes/export.txt unified-research
/book-to-skill ~/workspace/project-docs/ project-knowledge
/book-to-skill "~/books/*.epub" my-library
這讓它更適合處理幾類經常被重新打開的資料:
- 團隊的 ADR、runbook、入職文檔和架構說明。
- 一組 RFC、API 合約或合規規範。
- 品牌語氣、設計原則和組件規範。
- 相關論文、自己的閲讀筆記和後續新增材料。
它還支持 fold-in:把新文件合併進已有 Skill,更新章節、主題索引、術語表和速查表。對於不斷變化的內部文檔,這比每次重新生成整套內容更實際。
比如,我可以把 Codex 倉庫的 README.md、根目錄 AGENTS.md,再加上官方 Prompting、AGENTS.md 和 Skills 指南整理成一個資料集合。以後詢問“根目錄規則、子目錄規則和可複用 Skill 應該怎樣分工”,Agent 就可以從不同來源裏找到對應依據,而不是隻返回一次網頁搜索的摘要。
這個例子也說明了它最適合的材料:不是讀完一次就結束,而是你會持續查閲、反覆應用,並且希望答案保留來源結構的內容。
先把快速路徑跑通
項目當前明確支持 GitHub Copilot CLI、Amp 和 Claude Code。以 Claude Code 為例,可以先把倉庫安裝到 Skill 目錄:
git clone https://github.com/virgiliojr94/book-to-skill.git \
  ~/.claude/skills/book-to-skill
處理技術書之前,先檢查本機可用的提取器:
python3 ~/.claude/skills/book-to-skill/scripts/extract.py --check
然後在 Agent 中調用:
/book-to-skill ~/Documents/thinkpython2.pdf think-python-2
流程會先詢問資料是技術型還是文字型,再顯示來源數量、頁數、預計 token、生成文件和成本估算。確認後才繼續生成。完成後可以按主題或章節調用:
/think-python-2 word frequency analysis
/think-python-2 ch13
/think-python-2 "what chapters do you have?"
第一次體驗,我會選一本章節標題清楚、自己有權處理的公開技術書。這樣最容易檢查章節識別、代碼塊保留和主題索引是否正確。
生成 Skill 之前先檢查這幾件事
這類工具最容易製造一個錯覺:文件生成齊全,就等於知識已經可靠。實際上,轉換後的 Skill 仍然需要抽查。
第一,確認提取模式。項目自己的測試裏,一份 103 頁技術 PDF 使用 pdftotext 只用了 0.1 秒,但沒有保留表格和代碼塊;Docling 用了 164 秒,保留了 48 張表格和 36 個代碼塊。速度和結構質量不能同時假設為最好。
第二,檢查章節邊界和主題索引。沒有明確 Chapter N、多欄排版或標題格式特殊的書,可能識別失敗,需要手動指定章節。
第三,不要把本地提取等同於數據不會離開機器。安全說明[6]寫明提取器本身不會上傳文件,但如果 Agent 背後的模型運行在雲端,送給模型的文本仍然受對應服務的數據條款約束。
第四,檢查文檔裏的惡意指令。7 月 30 日發佈的 v1.3.0[7]加入了不可見 Unicode 清理、DOCX XML 防護和生成 Skill 的 prompt injection 掃描。這些改動說明維護者正在處理真實的 document-to-context 供應鏈風險,但掃描器被項目明確標為 advisory,不能代替人工審閲。
第五,核對版權。轉換器使用 MIT 協議,不代表輸入的書也能重新發布。自己購買的書可以作為個人學習資料處理,生成後的 Skill 是否能分享,仍取決於原始內容的許可。
book-to-skill 這周的增長有一個很清楚的原因:它沒有繼續承諾“更長上下文能裝下更多資料”,而是把問題換成了“怎樣讓 Agent 下次只讀真正需要的部分”。
對於只查一次的 PDF,轉換整套 Skill 可能沒有必要。對於一本會反覆引用的技術書,或者一組每天都要遵守的團隊文檔,先把結構整理好,下一次提問才真正開始省時間。
- 項目倉庫:https://github.com/virgiliojr94/book-to-skill[1]
References
- README: https://github.com/virgiliojr94/book-to-skill
- Skill 生成規範: https://github.com/virgiliojr94/book-to-skill/blob/master/SKILL.md
- 架構文檔: https://github.com/virgiliojr94/book-to-skill/blob/master/docs/architecture.md
- 性能數據: https://github.com/virgiliojr94/book-to-skill/blob/master/docs/performance.md
- 用法文檔: https://github.com/virgiliojr94/book-to-skill/blob/master/docs/usage.md
- 安全說明: https://github.com/virgiliojr94/book-to-skill/blob/master/SECURITY.md
- v1.3.0: https://github.com/virgiliojr94/book-to-skill/releases/tag/v1.3.0