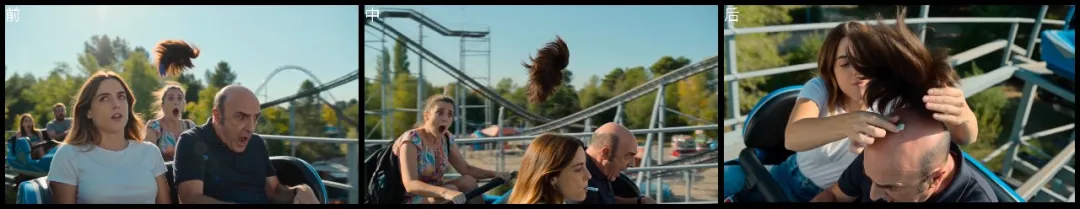用三年案例庫同十萬積分,佢開源咗 goodcase.ai:AI 提示語真偽驗證同模型橫測結果
作者卡爾同阿湯係做 AI 視頻、Agent 嘅創作者,過去三年佢哋喺飛書知識庫儲低咗上千條生成案例,每條都帶住完整提示語、模型版本同效果。眼見近兩周視頻模型大爆發,佢哋想搞清楚一個問題:社交媒體上啲爆款案例嘅提示語究竟係真定假?點解同一條提示語,換個模型效果差咁遠?
為咗解答呢個問題,佢哋將三年嘅案例庫開源成網站 goodcase.ai,並用新出嘅 Seedance 2.0 Fast 、MiniMax H3、Wan 3.0 三個模型,燒咗十萬積分做系統性橫測。測試覆蓋多素材參考、文生視頻(打鬥、時間倒退、餅乾廣告)同圖生視頻(第一人稱 vlog),全部用同一批提示語跑,再交叉驗證。
整體結論係 :大部分網上案例嘅提示語係真,但好依賴模型,唔可以直接照搬。佢哋發現 Seedance 2.0 Fast 綜合能力最均衡,喺八個唔同場景都冇大問題,平均抽卡約兩次,適合量產;MiniMax H3 喺創意同二維動畫表現突出;Wan 3.0 可以出 30 秒,但而家通道擠。佢哋亦將超過 5 個同類案例抽象成「Skill 」,方便日後調用。
結論 :Seedance 2.0 Fast 綜合最穩定,平均抽卡約 2 次,適合做量產工作流第一個節點。
方法 :用同一批提示語跨模型跑交叉驗證,踢走冇提示語嘅案例,先確認案例真偽。
差異 :H3 適合創意/二維 PV,Wan 3.0 可直出 30 秒但通道擠;模型各有強項。
啟發 :真正成本 係「抽卡率 」,唔係 API 單價;要計算平均生成幾多次先出一條合格片。
行動 :goodcase.ai 免費開放,超過 5 個同類案例就會被抽象成 Skill,可放入 CodeX 重用。
連結
goodcase.ai
GoodCase.ai
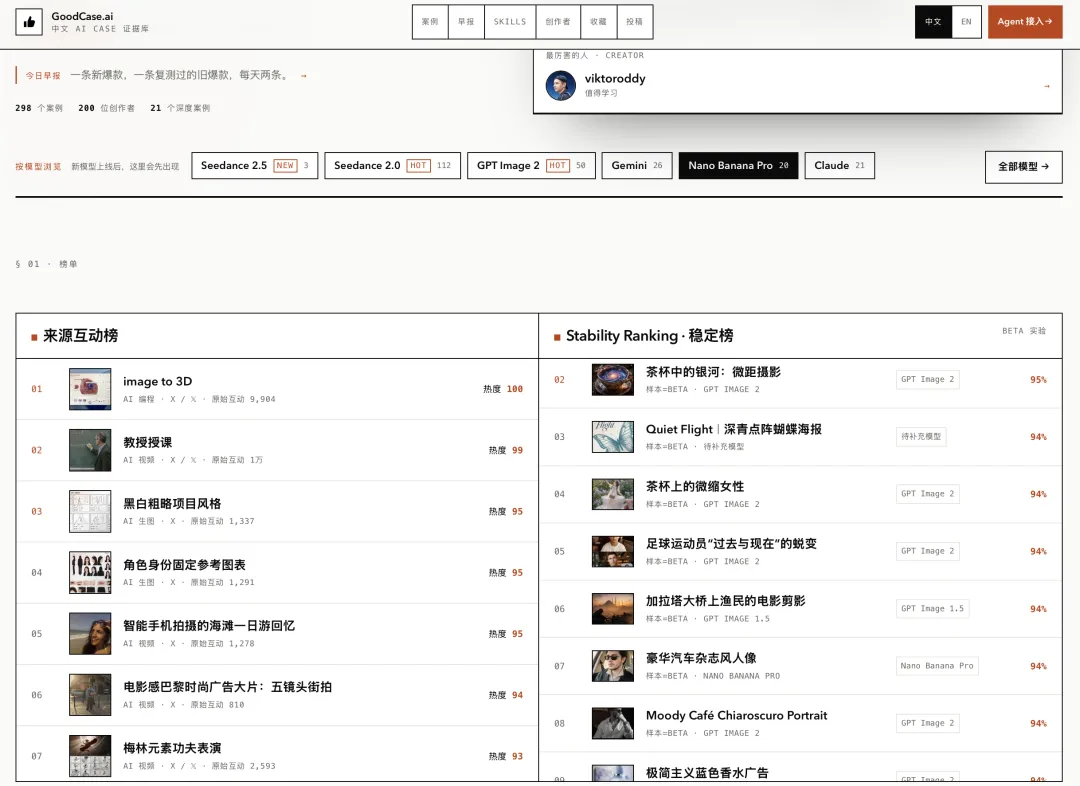
免費開放嘅 AI 提示語案例網站,收錄三年實測案例、跨模型驗證結果同技能化提示語,今次橫測嘅所有提示語同對比視頻都可以喺度睇。
電影感十足的韓國動作場面:一條狹窄而陽光明亮的城市巷弄,兩側是磚砌建築、空調外機和堆疊的木託盤,一家醒目的 GS25 便利店坐落其中。
一名身材矯健的年輕女子留着金色長髮,紮成高馬尾。她身穿修身的粉色長袖運動短上衣,下身搭配同色緊身運動褲和乾淨利落的粉色運動鞋。她的臉龐、頸部和上胸泛着一層細密汗光,顯然剛剛結束訓練,但神情依舊沉着、專注而堅定。
她與一羣身穿黑色運動服和連帽衫、來勢洶洶的年輕男子正面對峙。沒有絲毫遲疑,她猛然衝上前,以精準而強勁的格鬥技巧展開反擊:快如閃電的拳擊、迴旋踢、肘擊、膝撞、掃腿,以及乾淨利落的摔投接連使出。她憑藉流暢而寫實的動作編排,將襲擊者逐個擊倒。
手持攝影機緊貼人物穿行於狹窄巷道之中,通過富有動感的運鏡、輕微的鏡頭晃動、真實的運動模糊和快速切換的視角,強化每一次撞擊的力量與緊張感。隨着衝突不斷升級,眾人接連重重摔在路面上,整場打鬥在極具電影感的節奏中持續推進。
背景裏,三名身穿整潔校服的韓國女學生站在 GS25 門口附近,震驚得一言不發,目不轉睛地注視着眼前的衝突。明亮的自然日光在磚牆和堆疊的木託盤上投下清晰利落的陰影,也照亮了空氣中的塵埃、地面的碎屑以及周圍真實細膩的環境細節。
最終,最後一名襲擊者倒在堆疊的木託盤旁。女子停下腳步,從容地重新調整格鬥架勢,整理了一下粉色運動短上衣,隨後自信地沿着陽光照耀的巷道離去。
超寫實真人實拍風格,韓國動作電影美學,高強度動作編排,清晰細膩的面部細節,符合真實物理規律的人體運動,電影級手持攝影,自然光效,逼真材質與院線電影級畫面品質。
作者卡爾同阿湯係做 AI 視頻、Agent 嘅創作者,過去三年佢哋將每次生成案例都記錄喺一個飛書知識庫,加埋有上千條。每一條都帶住完整提示語、當時嘅模型版本,同埋生成出嚟嘅效果。
三年入面最早一條記錄係 2023 年,嗰陣時 Runway Gen-2 先啱啱出,為咗一條 4 秒影片都要開香檳。
但係隨住模型迭代,佢哋發現一個好睏擾嘅問題:每次模型一更新,之前儲落嘅案例就開始大面積失效。佢於是開始懷疑:社交媒體上啲幾十萬播放嘅案例,啲提示語到底係真定假?如果係真,點解換個模型就差咁遠?如果係假,中間又經過幾多人工執靚?
作者揀咗近兩周新出嘅模型 :Seedance 2.0 Fast 、MiniMax H3 同 Wan 3.0,API 價錢分別係 0.6 元/秒、0.5 元/秒同 0.6 元/秒。佢哋由首輪 136 個 case 入面揀咗呢三個價格接近嘅模型,用同一批提示語,喺 720P 檔位逐個場景去跑。
成個測試燒咗十萬積分,目的就係要揀出性價比最高、表現最穩定嘅模型。
佢哋用咗三類提示語嚟覆蓋最有區分度嘅輸入方式:多素材參考(圖片+音頻+視頻)、純文字生視頻、圖生視頻。測試過程透過 API 直接調用模型,避免其他 Agent 內置提示語影響結果。
多素材參考 :用 Kpop MV 提示語,考長指令遵循同埋音頻節奏理解能力。
文生視頻 :揀咗多人打鬥、時間倒退、餅乾廣告三個地獄級場景,迫出模型極限。
圖生視頻 :用第一人稱 vlog 測人臉穩定度同生活感,係量產電商片最易崩嘅位。
呢套方法唔係紙上談兵,作者之前做 AI 視頻做到第一個一百萬播放,就係咁樣一輪一輪燒積分燒出嚟。
多素材 Kpop MV 方面,H3 初睇唔錯,但中遠景人臉變形;Seedance 2.0 Fast 人臉最清、卡點啱、動作設計最似 Kpop ;Wan 3.0 人臉穩定,但開頭鼓點冇對應動作。
Seedance 2.0 Fast 人臉最清、卡點啱、動作設計最似 Kpop 。
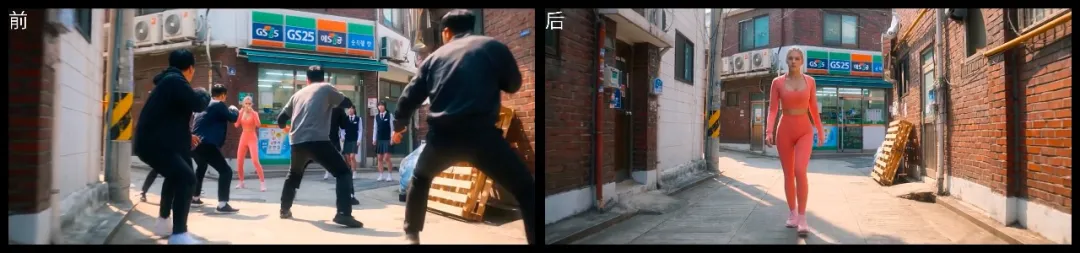
文生視頻打鬥場景,H3 快動作會糊,對手有啲企定定俾人打;2.0 Fast 最出色,識利用灰塵、路人反應同唔同景別嚟營造打擊感;Wan 3.0 有物理穿牆 bug,尾段人物直情消失。
Wan 3.0 有物理穿牆 bug,尾段人物直情消失。
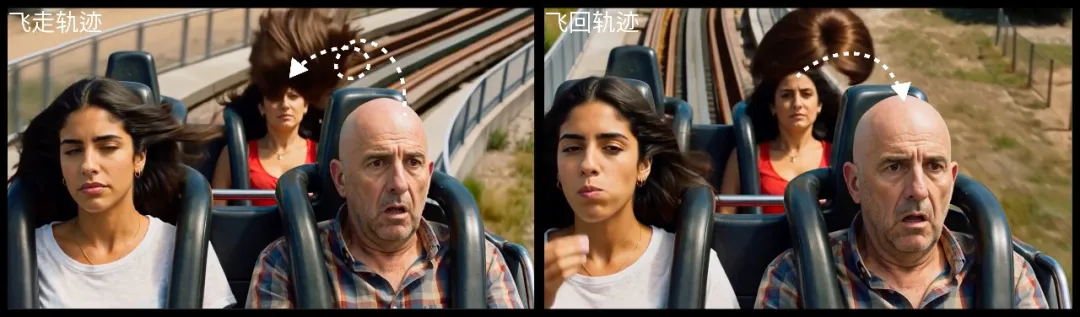
時間倒退場景,2.0 Fast 用 15 秒保住咗最難嘅因果鏈,效果接近之前喺 2.5 上跑嘅版本。
餅乾廣告入面,H3 嘅動態設計同水果粒效果靚,但 2.0 Fast 完成度最高,拉絲果醬真實,仲識用懸浮效果做產品轉換,最適合批量做四種口味。Wan 3.0 嘅餅乾賣相好,物理曲線真實,但掰開嗰下果醬似果汁。
2.0 Fast 完成度最高,拉絲果醬真實,仲識用懸浮效果做產品轉換。
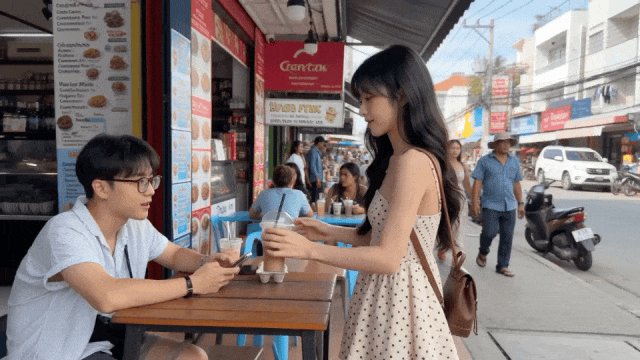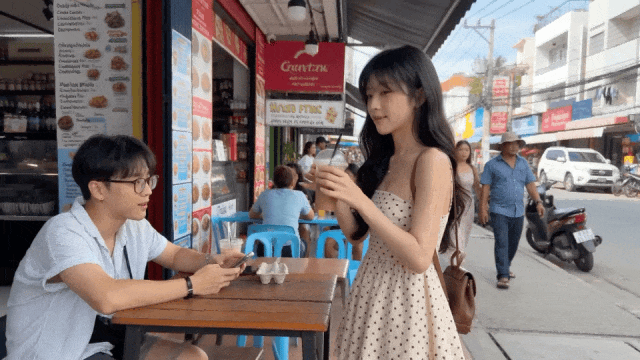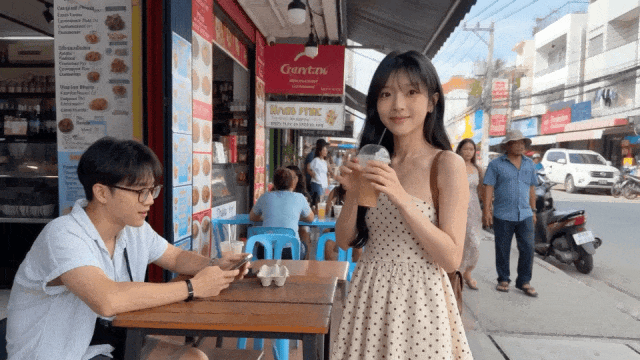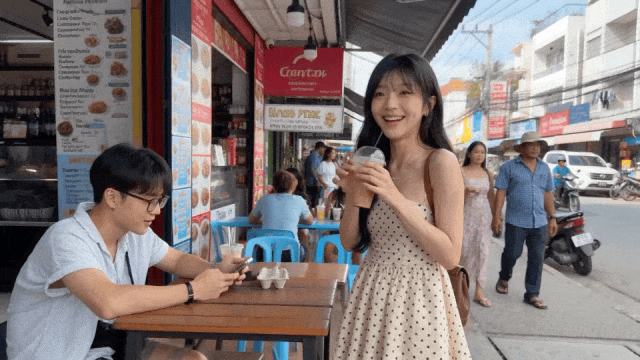
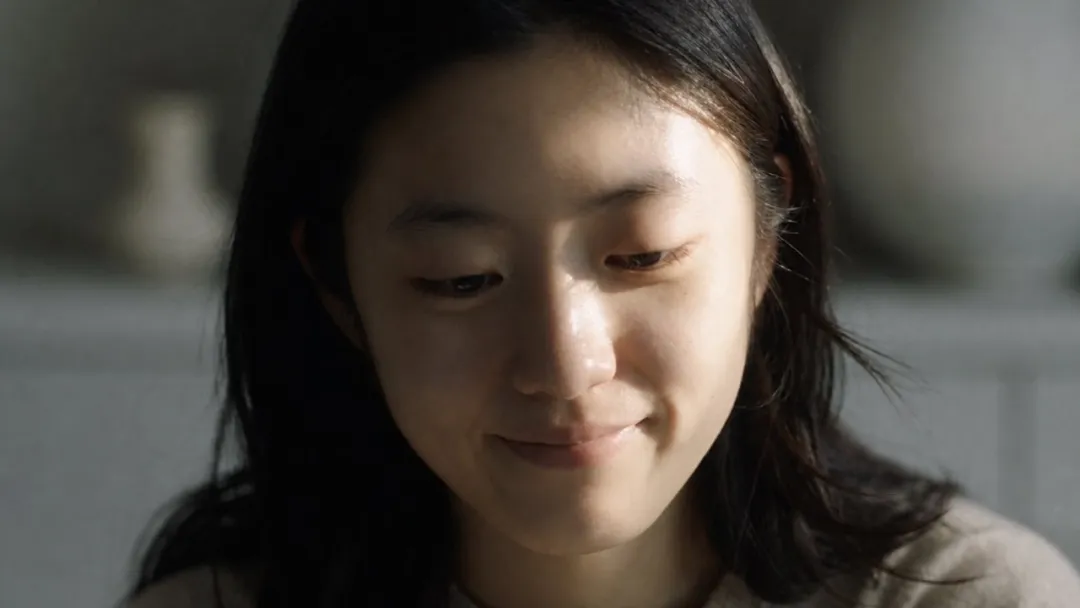
圖生視頻第一人稱 vlog,H3 動作未做完就跳下一幕,人臉前後不一致;2.0 Fast 完整度好高,人臉、氣質同手持紀錄感由頭到尾冇斷,笑容自然;Wan 3.0 畫面冇問題,但配樂似兩段音樂撈埋,要用剪輯軟件分離音頻換走。
2.0 Fast 完整度好高,人臉、氣質同手持紀錄感由頭到尾冇斷,笑容自然。
多素材 :2.0 Fast 的平衡最好,人臉、卡點、動作設計兼得。
打鬥 :2.0 Fast 靠環境反應做出真力量感,Wan 3.0 有物理 bug。
時間倒退 :2.0 Fast 因果鏈完整,Wan 3.0 冇還原假髮。
TVC :2.0 Fast 完成度最高,適合批量改口味。
Vlog :2.0 Fast 人臉同質感最穩,H3 動作斷裂。
綜合八個場景,作者認為 Seedance 2.0 Fast 綜合能力最均衡,每個場景都冇大問題,速度快、成本低,好適合批量產出。佢會係作者跑 case 嘅默認選項。
H3 就適合創意類型視頻或者 2D 動畫結合,建議先用 768P 試效果再上 2K。
Wan 3.0 綜合能力唔錯,亦都出到 30 秒片,但而家通道擁擠,好多時要凌晨先跑到。
另一個好易忽略嘅位係抽卡率。API 價錢只係帳面數字,真正決定成本係平均要生成幾多次先出一條用到嘅片。今次測試入面,2.0 Fast 喺 8 個 case 平均抽卡次數約 2 次,呢個先係量產最關心嘅數。
Seedance 2.0 Fast :綜合最穩,抽卡率低,適合成為量產工作流第一個節點。
MiniMax H3 :創意/2D 動畫方向效果好,但人臉穩定度要再確認。
Wan 3.0 :可直出 30 秒,但而家排隊慢,要避開繁忙時間。
作者回想最初嘅問題 :網上啲案例提示語係真定假?跑完十萬積分後,佢話大部分係真,但真唔代表直接用到,因為模型之間差異太大。
GoodCase 嘅價值,就係話你知邊個模型、邊啲參數之下可以復現,換模型要點調整。
佢哋希望將案例抽象成 Skill,由飛書文檔變成一個經過驗證嘅實戰庫。好嘅提示語同方法論,如果唔去驗證、唔去整理、唔做跨模型交叉測試,就只會係資訊流入面一閃而過嘅碎片。
而家 goodcase.ai 已經免費開放,文章入面所有提示語同對比視頻都整理好,大家可以上去睇。
「選模型冇標準答案,只有適合自己場景嘅最優解。 」
這 呢兩個禮拜,影片模型更新快到癲咗。 Seedance 2.5,MiniMax H3,Wan 3.0, F lux3, M eta M use V ideo ㅤ 和 G rok I magine V ideo, 我淨係睇各種demo都睇到凌晨一兩點。每個case都想親手跑一遍,整理好提示詞方法之後再出post,但就算我每日更新圖文同影片都出唔曬呢啲GoodCase。 所以我開源咗一個AI提示詞案例網站,叫 goodcase.ai 。
ㅤ
01|我開源咗維護咗三年嘅案例庫 平時做唔完嘅case我都會存落一個飛書知識庫,三年喇,入面存咗上千條AI影片、AI前端、Agent等等生成記錄。每一條都帶住完整嘅提示詞,帶住我當時測試嘅模型版本,帶住當時生成出嚟嘅效果。
三年。
呢個文檔,最早一條記錄係2023年寫嘅。嗰陣時Runway Gen-2啱啱出,我仲為咗一條4秒嘅影片開香檳慶祝。到今日,Seedance 2.5已經可以直接出30秒嘅畫面喇。
嗰陣時提示詞仲好短,好似呢條影片咁得一句, 風吹鬱女仔嘅頭髮,女仔悲傷噉望住前面。
最近呢個文檔有一個令我越嚟越焦慮嘅問題,
每次模型一更新,之前儲落嘅案例就開始大面積失效。唔止AI影片,前排流行用Agent測UI生成,過幾個禮拜轉到3D遊戲,再過幾個禮拜而家又繼續內卷UI。燒積分測出嚟嗰套方法論,都可以叫做Skill,可能半個月就冇用。
我一路喺度諗一個問題,
呢啲喺X上成日都有幾十萬播放嘅案例,嗰啲提示詞,到底係真定假?
如果係真,點解我用同樣嘅提示詞,換一個模型跑出嚟嘅差距咁大?如果係假,咁我哋每日刷到嗰啲Amazing嘅效果,中間到底經過咗幾多人手幹預,幾多剪接,幾多揀幀?
呢個問題困擾咗我好耐。耐到我決定唔再淨係存案例,我要做一件更加認真嘅事。所以我做咗一個網站, GoodCase.ai 。
我唔想做嗰種追住模型更新食一波流量嘅案例合集網站,我見過太多呢種喇,風口嚟就堆一波內容,風口過咗就冇人維護。我想做嘅 就係建立一個經過驗證、持續迭代、將優秀作者嘅方法論都總結出嚟嘅案例庫。
我驗證提示詞真偽嘅方法都好樸素,
首先將冇提示詞嘅案例全部踢走,因為你唔知中間溝咗幾多水。然後拎同一批提示詞,喺唔同模型上交叉驗證,睇嚇到底係提示詞犀利,定係淨係某個特定模型能力上咗去。最後,將嗰啲真正跨模型都跑得通嘅多個案例,抽象成一個一個嘅Skill,方便將來唔理模型點迭代,都可以直接調用。
呢套方法聽落有啲麻煩,但係我自己就係咁樣過嚟。當初做AI影片做到第一個100萬播放量,就係一輪一輪燒積分測出嚟。
ㅤ
02|一次過跑幾百條AI影片,點樣揀性價比最高 我意識到,呢兩個禮拜狂出新模型係一個絕佳嘅測試窗口。手上有三年儲落嘅提示詞庫,眼前有新出嘅模型,咁就不如索性做一次系統性嘅橫向測試,將goodcase.ai第一版做好佢,用呢兩個禮拜出嘅模型,跑一批經得起考驗嘅提示詞案例,順便揀出表現最穩定嘅模型,畢竟跑AI影片絕對要盡量減少積分嘅消耗。
十萬積分,就咁樣燒咗出去。
由首輪136個case入面,由720P檔入面揀咗三個價格最接近嘅模型,Seedance 2.0 Fast、MiniMax H3、Wan 3.0,API價格分別係0.6元/秒、0.5元/秒、0.6元/秒,揀出嚟表現最穩定而且綜合成本 最划算 嗰一個。
所以接下來就係我哋一齊kukuku拎最近儲落嘅提示詞庫,逐個場景將呢三個模型一個一個試勻曬。我揀咗三類提示詞嚟測 覆蓋咗影片生成入面最有區分度嘅三種輸入方式。
ㅤ
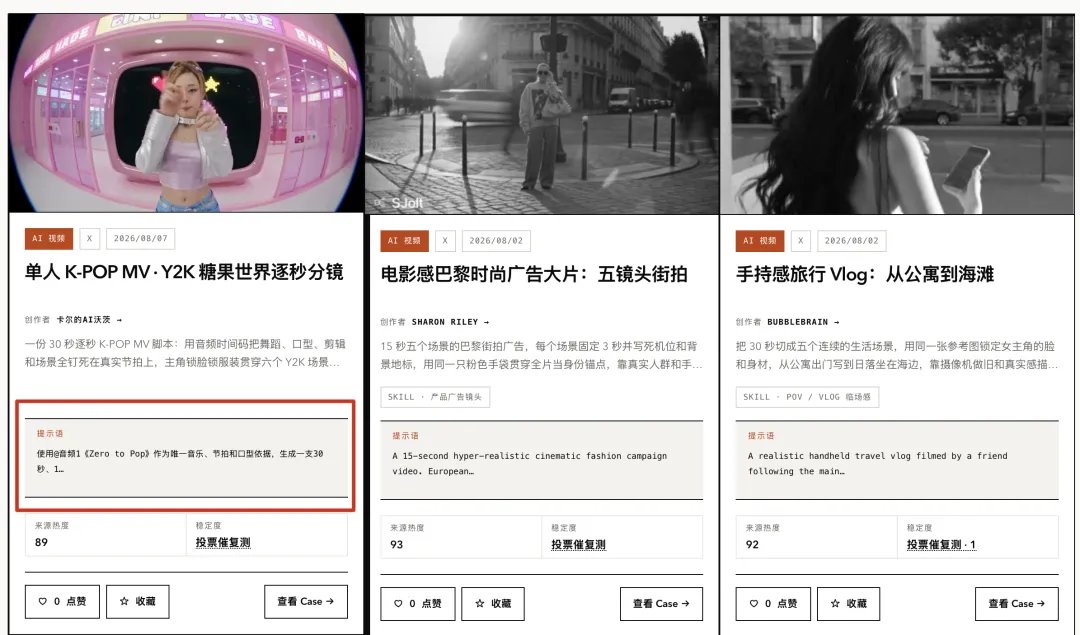
03|多素材參考生成影片 超多人嚟問我攞呢個Kpop MV嘅超長提示詞,而家都完整上線喇。
咁我對多素材嘅定義就係除咗圖片仲會有音頻、影片嘅元素。呢種場景對模型嚟講就係,佢要理解你畀嘅圖風格,仲有音頻嘅節奏,如果要想畫面卡中拍子嘅話,喺提示詞階段就要寫比較長嘅提示詞,所以對模型嘅長指令跟從能力都有要求。
咁如果大家想做出嚟嘅MV有一種精準卡點嘅感覺,我建議可以用AI音樂工具生成固定時間段,再將佢作為參考嚟生成影片,咁樣效果會比截取一段音頻更好。
每個模型都係生成15秒,720p清晰度,提示詞用嘅係一樣,呢個都係Goodcase而家內置嘅流程,通過API調用唔同模型,咁樣都唔會受到Agent本身內置嘅提示詞同skill影響。
為咗等大家有更加沉浸嘅觀看效果,我將三個影片拼埋一齊。每條影片 都 係15秒,由上到下分別係Minimax H3、Seedance 2.0 fast、Wan 3.0。
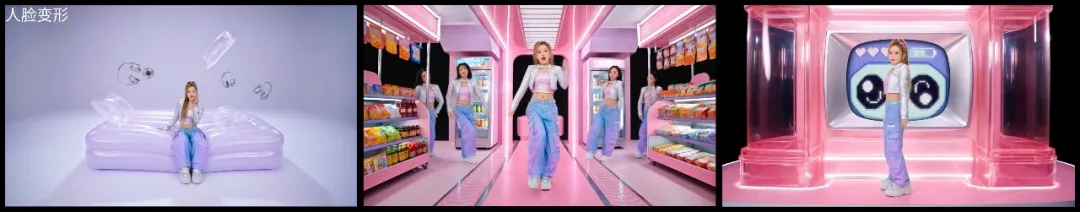
首先係H3,啱跑出嚟嗰陣時乍睇感覺都幾唔錯,風格、動作節奏、卡點、場景都冇任何問題,但中遠景鏡頭出現咗人臉變形 同五官模糊嘅感覺。
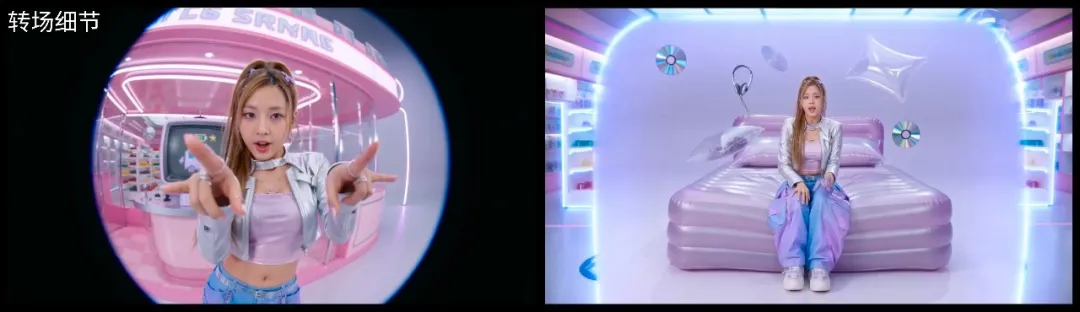
接着 跟住係Seedance 2.0 fast,佢人臉最清晰,令整體觀感更加舒服,每個節拍嘅卡點基本上都對得啱,由開頭嘅手部舞蹈動作到最後嘅掛電話,動作設計最符合kpop嘅感覺。開頭仲有魚眼視角同後面嘅光效轉場,呢啲細節都令到成條片更加有層次。
最後Wan 3.0 整體都唔錯,相比H3人臉更加穩定。 。 舞蹈動作除咗開頭幾個鼓點冇對應嘅舞蹈動作之外,其餘舞蹈動作嘅卡點都對得啱。
ㅤ
04|文字生成影片 我揀嘅場景係多人打鬥、時間倒流同 餅乾廣告 。
呢個場景我揀得比較刻意,就係想逼到模型去極限。打鬥考驗嘅係動態生成能力,畫面入面多個人打交,動作要連貫,力量感要真實。時間倒流更加狠,假髮要由半空回到男人頭上,呢種逆向物理邏輯對模型嚟講幾乎係地獄級考試。餅乾廣告就係考審美,同埋模型點樣表達水果餡餅乾同水果嘅關係。
而且呢組完全冇任何圖片參考,淨係靠文字描述嚟驅動畫面,做廣告嗰陣時靠嘅就係模型自己嘅審美。先上打鬥,
電影感十足的韓國動作場面:一條狹窄而陽光明亮的城市巷弄,兩側是磚砌建築、空調外機和堆疊的木托盤,一家醒目的 GS25 便利店坐落其中。
一名身材矯健的年輕女子留着金色長髮,紮成高馬尾。她身穿修身的粉色長袖運動短上衣,下身搭配同色緊身運動褲和乾淨利落的粉色運動鞋。她的臉龐、頸部和上胸泛着一層細密汗光,顯然剛剛結束訓練,但神情依舊沉着、專注而堅定。
她與一羣身穿黑色運動服和連帽衫、來勢洶洶的年輕男子正面對峙。沒有絲毫遲疑,她猛然衝上前,以精準而強勁的格鬥技巧展開反擊:快如閃電的拳擊、迴旋踢、肘擊、膝撞、掃腿,以及乾淨利落的摔投接連使出。她憑藉流暢而寫實的動作編排,將襲擊者逐個擊倒。
手持攝影機緊貼人物穿行於狹窄巷道之中,通過富有動感的運鏡、輕微的鏡頭晃動、真實的運動模糊和快速切換的視角,強化每一次撞擊的力量與緊張感。隨着衝突不斷升級,眾人接連重重摔在路面上,整場打鬥在極具電影感的節奏中持續推進。
背景裏,三名身穿整潔校服的韓國女學生站在 GS25 門口附近,震驚得一言不發,目不轉睛地注視着眼前的衝突。明亮的自然日光在磚牆和堆疊的木托盤上投下清晰利落的陰影,也照亮了空氣中的塵埃、地面的碎屑以及周圍真實細膩的環境細節。
最終,最後一名襲擊者倒在堆疊的木托盤旁。女子停下腳步,從容地重新調整格鬥架勢,整理了一下粉色運動短上衣,隨後自信地沿着陽光照耀的巷道離去。
超寫實真人實拍風格,韓國動作電影美學,高強度動作編排,清晰細膩的面部細節,符合真實物理規律的人體運動,電影級手持攝影,自然光效,逼真材質與院線電影級畫面品質。
H3喺快節奏動作嘅時候明顯成個人變到濛查查。 情況 , 然後整體打鬥感係有,但係感覺好似對手都企喺原位等住畀人打咁。
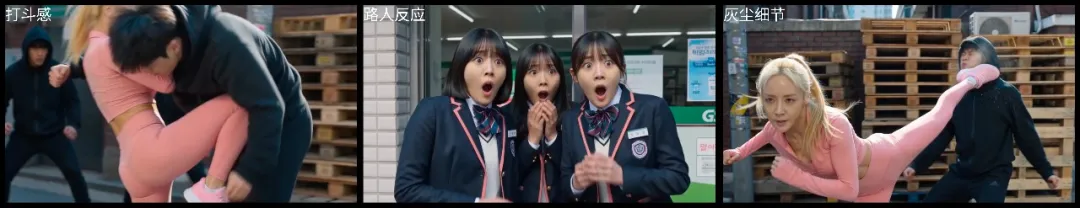
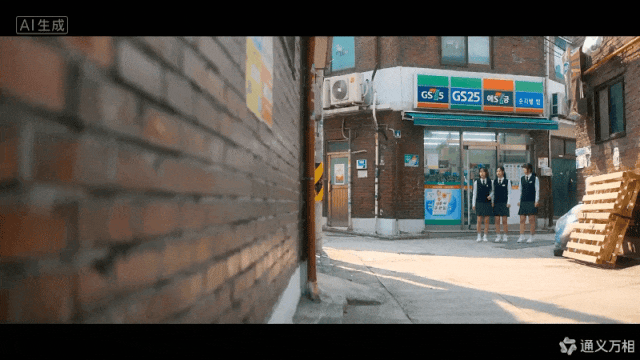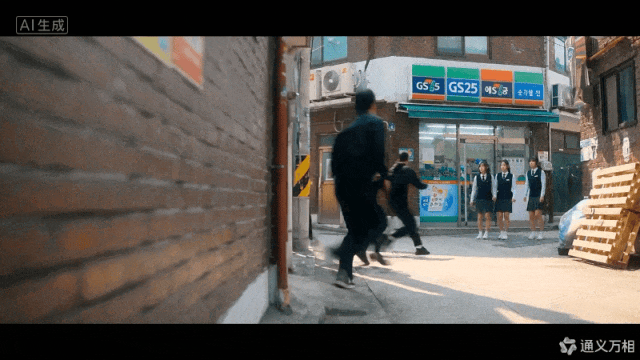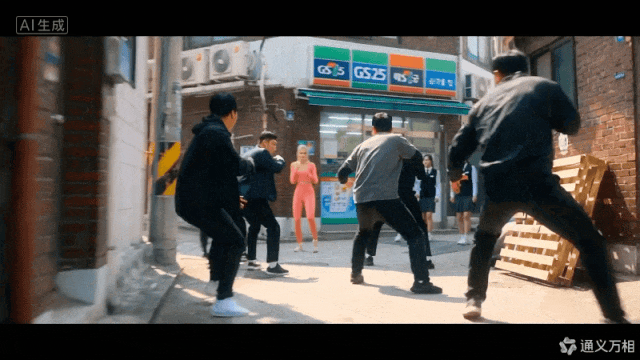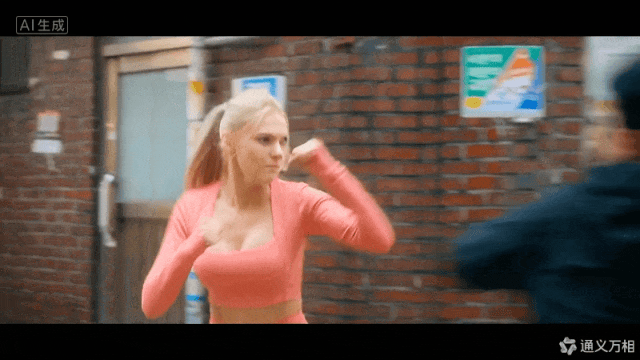
2.0 fast嘅打鬥感真係好強 由人物出場嘅對峙,到被打嘅人撞到 空調 激起塵起嚟 體現打擊感, 中間仲穿插咗 路人嘅反應, 結尾背住人物一個飛踢動作都好靚仔。 整理衫嘅過程都非常乾淨利落。 呢度佢最值得讚嘅係知道一場打鬥唔係兩個喺畫面中間亂咁揮手。拳腳碰到人,環境要有反應,周圍嘅人都要知呢度打緊交。灰塵、路人、唔同景別同最後整理衫嘅收尾都係服務緊同一段表演,唔係淨係靠快切嚟扮有力量,對手嘅反應同女主角嘅動作都接得更加順。
Wan 3.0 主要是 有啲物理bug,人物係穿牆出嚟, 不過 唔同景別切換得好快,可以體現到打鬥 感同力量感。
但係最後個鏡頭,人竟然全部消失咗。
OKOK,跟住就係經典嘅時間倒流,呢個比上個case嘅差距更加明顯,而呢度我就將一個30秒嘅提示詞 壓縮成15秒 塞畀三個模型去跑,睇嚇大家嘅表現點樣啦。
寫實電影感,白天遊樂園過山車。強烈陽光與疾風,軌道和背景呈現真實運動模糊,輕微手持感,細膩膚質,天然膠片顆粒。
0-4秒|中景:過山車高速俯衝轉彎。前排坐着一名二十歲出頭、神情淡定又略顯無聊的年輕女子,長髮迎風飛舞;身旁是一名戴着逼真假髮的中年男人,後排坐着另一名女子。
4-7秒|動態跟拍:強風猛地掀飛男人的假髮,露出光頭。假髮旋轉着向後飛去,凌亂地罩在後排女子臉上。眾人震驚尖叫的瞬間,時間驟然靜止,只有前排女子還能活動。
7-11秒|緩慢環繞:鏡頭掠過凝固在空中的髮絲、張大嘴的光頭男人,以及被假髮矇住臉的後排女子。年輕女子翻了個白眼,無聲嘟囔:“靠,又來。”她掏出一片口香糖,拆開、放入口中咀嚼。隨後整個世界精準倒放:假髮從後排女子臉上飛回,退至剛要脱離男人頭頂的瞬間,再次定格。
11-13秒|近景:年輕女子取出口香糖,按在男人頭頂中央,再把正在翹起的假髮用力壓回原位、撫平粘牢。她若無其事地坐好,嘴角浮現一絲隱秘笑意。
13-15秒|中景:時間恢復正常,過山車繼續俯衝。男人摸到假髮仍牢牢在位,先是困惑,隨即如釋重負地笑了。年輕女子目視前方,已經嚼起一片新的口香糖,神情平靜而滿足。
照片級真實,電影級時間連續性,人物外觀穩定;精準的風力、頭髮與假髮物理效果;運動模糊僅作用於移動物體;自然電影光影與濃郁膠片顆粒,無畸變、無穿幫,節奏緊湊,具有高重看價值。
H3最明顯就係架車冇停到,雖然係慢咗。然後假髮飛返嚟嘅過程有啲奇怪,都 可能係因為飛返嚟嘅軌跡冇跟返原本軌跡倒返轉頭嘅原因, 但係仲可以接受。
唔講唔得,雖然我喺同一個提示詞喺2.5上面都跑過,但係2.0 Fast嘅表現都真係幾吸引我。
首先就係,佢會通過已經係時間停止嘅畫面,再通過鏡頭轉換,體現到假髮倒回同將嚼過嘅香口膠貼返去呢件事係同時發生。整體畀我嘅感覺係,雖然話佢做咗慢鏡頭,但我可以feel到佢係一瞬間完成呢個時間倒流動作,同我之前用seedance2.5做嘅可以有80%相似度。
最後就係 W Wan 3.0呢次有大硬傷,冇將架車完全停低,15秒內都冇將假髮還原返嚟。
跟住就係經典TVC喇,
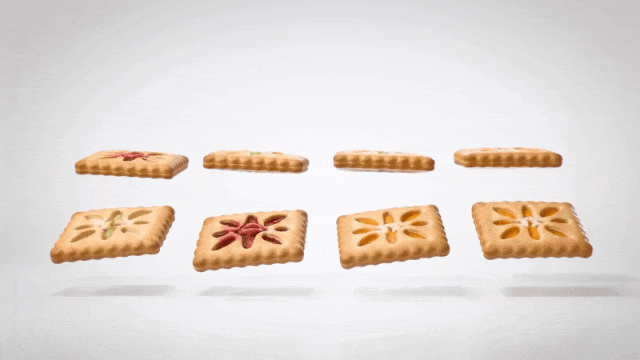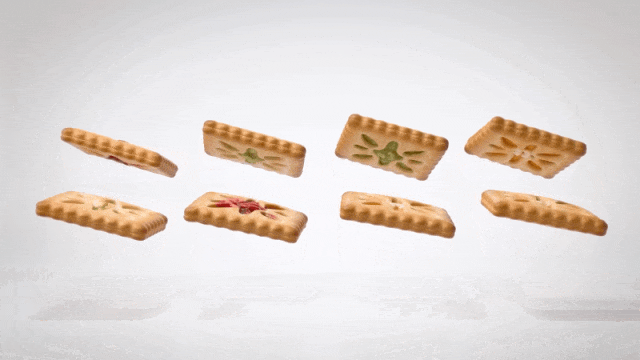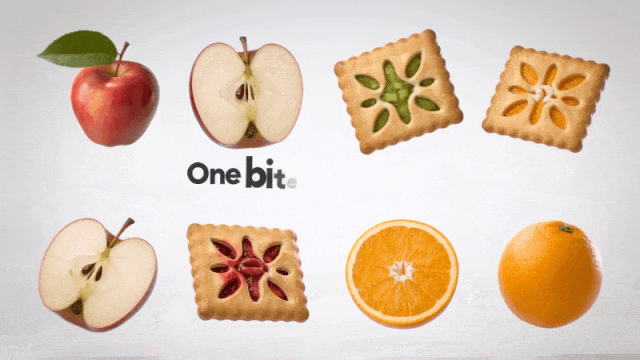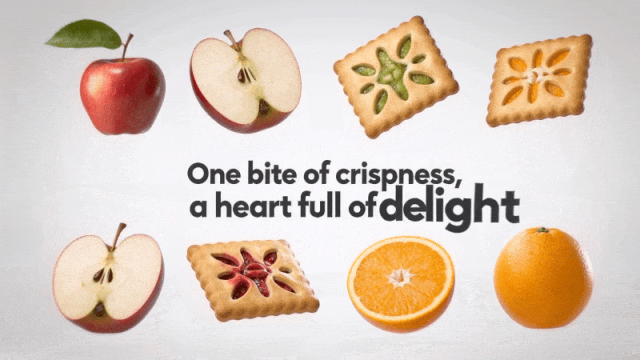
明亮繽紛的商業廣告風格,以水果夾心餅乾為絕對主角,呈現草莓、蘋果、葡萄和橙子四種口味。
餅乾與對應水果組成秩序感強烈的幾何陣列,畫面乾淨高級,富有鮮明節奏。開場由水果快速聚焦視線,音樂重拍同步切入;隨後,不同口味的餅乾整齊列隊,並迅速切換至產品特寫。
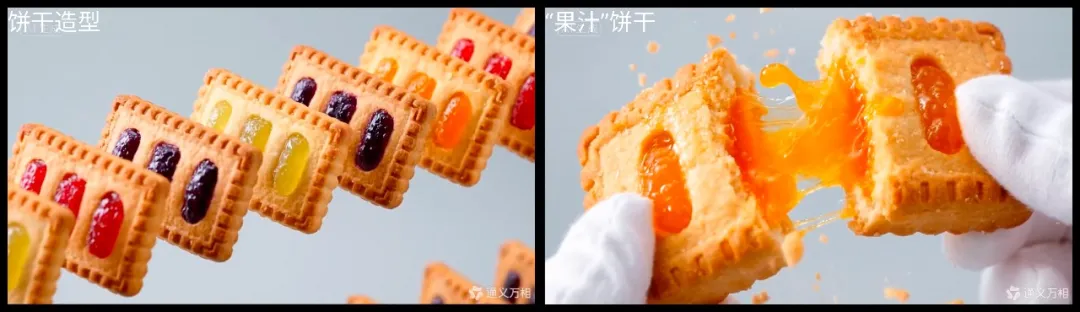
高潮部分,一塊餅乾被瞬間掰開,畫面隨即進入慢動作:水果夾心迸裂流出,餅乾碎屑四散飛濺,充分放大餡料的多汁質感與酥脆顆粒的衝擊力。隨後,多塊餅乾橫向排列,以富有節奏的拋物線軌跡騰空翻飛,突出產品整齊有序的視覺美感與豐富多樣的口味。
緊接着,剪輯重新加速。結尾處,英文文案“One bite of crispness, a heart full of delight”伴隨強烈節拍逐詞快速出現,文字動效與產品定格畫面精準配合。最終以具有品牌感的畫面收尾:餅乾與水果由中心向四周放射展開,營造年輕、活力、美味又讓人忍不住分享的廣告氛圍。
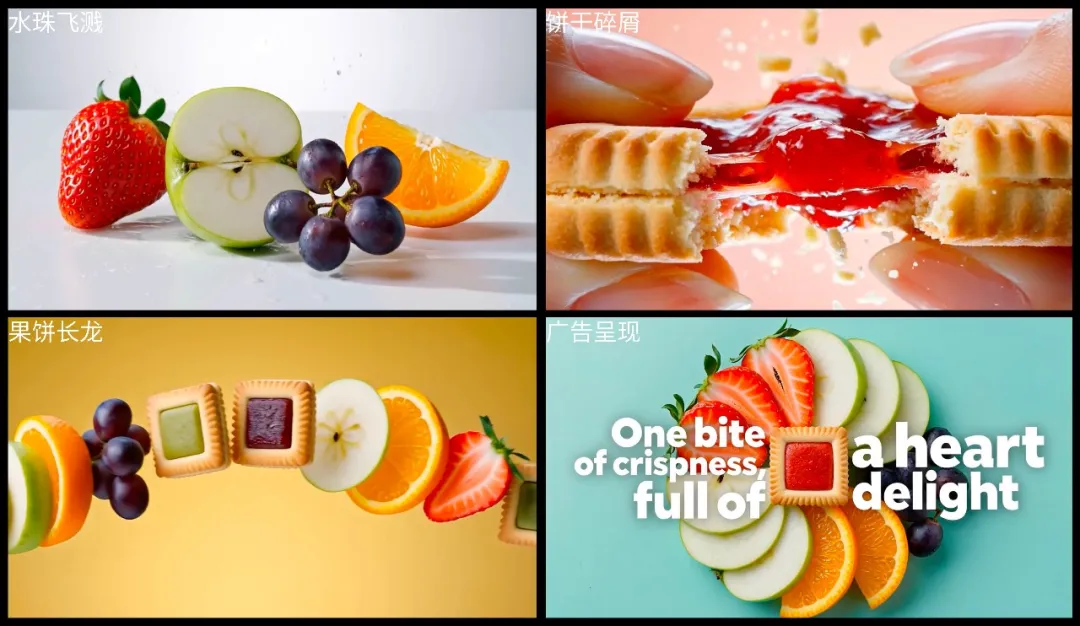
咁首先,我覺得H3做咗一個水果同餅乾長龍嘅拼接效果,都幾好睇。 水果跌落嚟飛濺嘅水珠、餅乾爆開嘅碎屑、水果餡拉絲、 水果餅乾排隊, 最後係畫面結尾嘅廣告標語,動態畫面設計能力 確實唔錯。
Seedance 2.0 fast整體完成度都好唔錯,成條片係可以直接用嘅程度,拉絲嘅果醬睇落最真實,結尾仲用咗懸浮效果嚟做餅乾同水果之間嘅切換, 尤其係嗰個餅乾反轉變成水果嘅效果,型型型。 如果我要將四種口味批量做成一條片,2.0 fast呢種比較穩定嘅產品主體同快速迭代依然會係我第一選擇。
再嚟Wan 3 .0, 我就好鍾意 它 佢做呢個餅乾,睇落比一般水果餅乾好食好多,而且佢將餅乾同水果拋上去,再落返嚟嘅物理曲線都畀人感覺幾真實。 ㅤ 就係中間掰開餅乾嗰陣,果醬有啲果汁感,橫截面都有啲唔一致。
ㅤ
05|圖片生成影片 呢part我揀咗一個第一人稱vlog。
呢個場景喺量產入面出現頻率太高。做電商嘅需要人物vlog視角嘅產品展示,而人臉,係所有影片生成模型最容易崩嘅地方。眼睛歪咗、嘴角抽搐、膚質變到好似塑膠咁,呢啲問題喺15秒片段入面只要出現一幀,成條就作廢。
我用咗好朋友 @ BubbleBrain 嘅提示詞,喺X上面有20萬播放,已經畀goodcase每日腳本收錄咗入去。
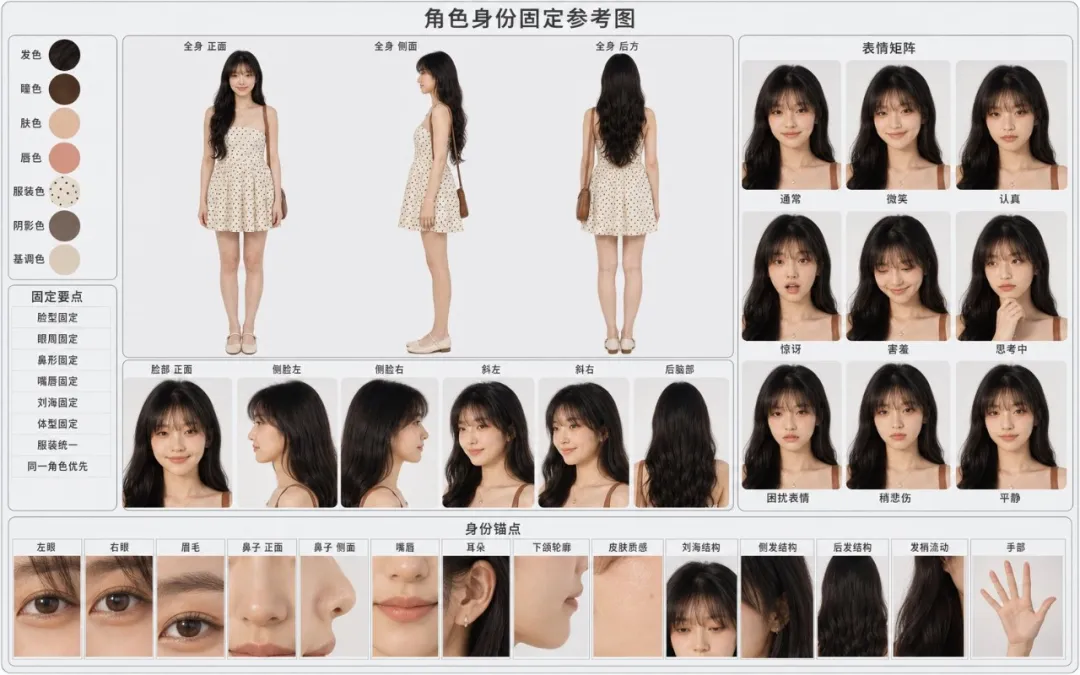
因為我冇原本提示詞入面嘅參考角色。所以我由影片入面截取咗兩幀,一幀可以睇清面部細節,另一幀可以睇到完整體態。然後,照樣用GoodCase收藏嘅角色身份固定參考圖表+GPT Image2,生成咗一張參考圖,等後面嘅模型可以用呢張圖嚟生成影片。
生成出嚟嘅角色圖係咁樣,表情矩陣、三視圖、唔同角度嘅頭部,以至五官細節同色卡都出曬嚟。
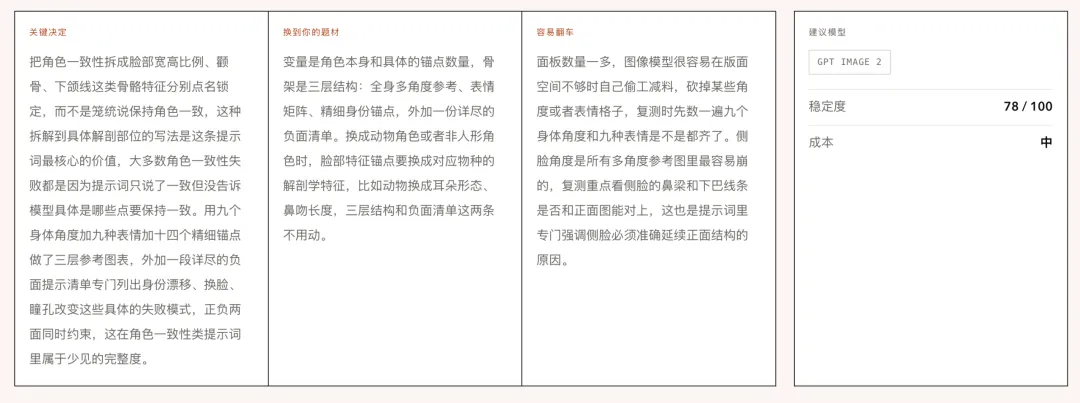
順便提一提,喺收錄case嘅同時,goodcase仲會分析目前呢個提示詞同庫入面其他提示詞嘅唔同點,以及點樣將佢改做我哋自己嘅題材。仲有就係用其他模型去運行呢個提示詞嘅時候,邊一個步驟容易翻車?
咁樣一來就會構成最終兩個判斷,
1. 將佢跑到一條合理嘅成片,成本係中高低? 2. 穩定度又係百分之幾多? 所以嚟喇,睇嚇三個模型喺第一人稱vlog嘅表現,
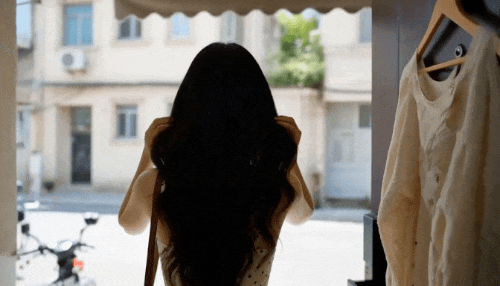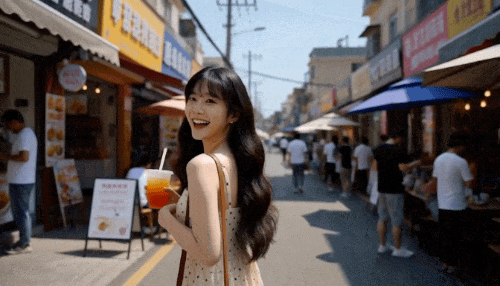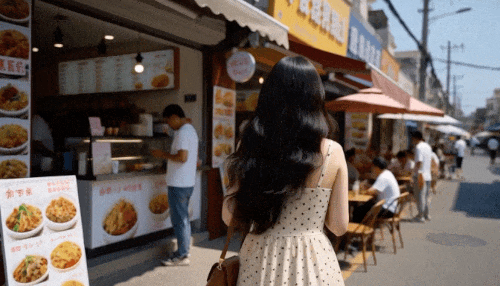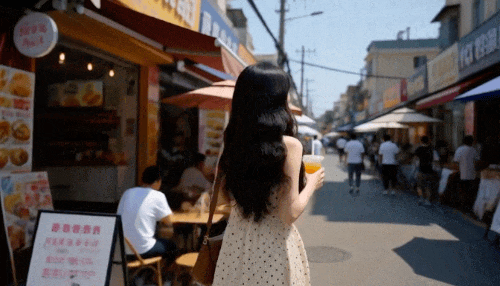
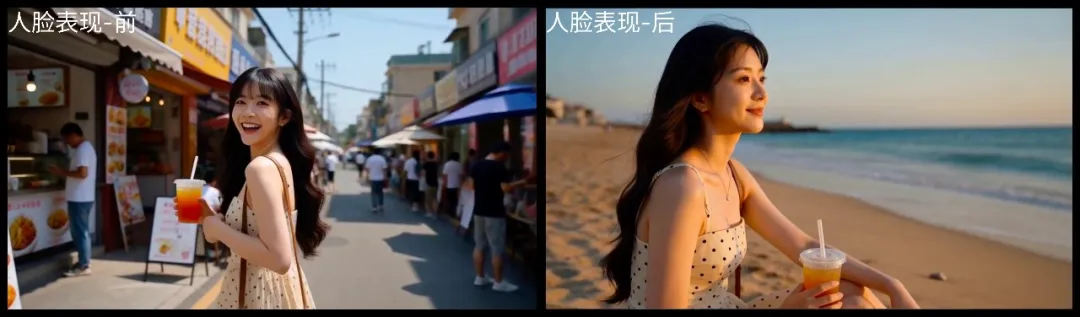
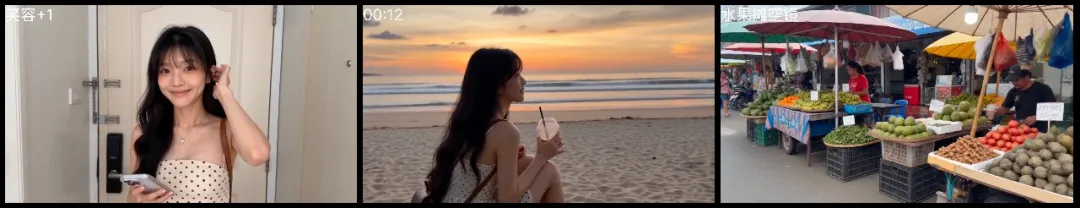
一段寫實的 15 秒手持旅行 Vlog,由朋友跟隨主角拍攝。使用參考圖片中的女性作為主角。在整個視頻中,始終保持她的面部身份、髮型、五官特徵和身材比例完全一致。畫面呈現真實的智能手機或微單相機質感,採用自然的手持運鏡、隨意的構圖、輕微的人為抖動,以及沒有表演痕跡的自然行為。0-3 秒:清晨出發。她揹着一個小揹包離開温馨的公寓,查看手機,對鏡頭微笑,整理頭髮,然後走進陽光明亮的社區街道。鏡頭從她身後近距離跟拍。3-7 秒:探索城市。她穿過熱鬧的本地街道,在一家小咖啡館買了一杯飲品,短暫看向鏡頭,並自然地笑起來。畫面快速、連貫地帶過街邊市場和小商店。7-12 秒:抵達海邊。她來到一座海濱小鎮,看見大海。海風吹動她的頭髮,她興奮地走向海邊,撿起一枚貝殼,然後回頭對鏡頭露出真誠的微笑。12-15 秒:黃金時刻收尾。她手裏拿着飲品,坐在海邊觀看日落。鏡頭緩慢向後移動,逐漸展現沙灘、海浪和温暖的傍晚光線,營造一段寧靜、私人的旅行回憶。視覺風格:真實自然的日常旅行 Vlog,具有紀錄片式寫實感、自然光線、即興的人物反應和連貫合理的鏡頭切換,同時始終保持人物身份一致。不要商業廣告式的電影感,不要刻意表演,不要誇張擺拍,不要生硬或人工化的轉場,不要文字疊加,不要 Logo,不要改變面部,也不要改變人物身份。呢個可能就係15秒時間有啲太趕。H3特別係喺攞奶茶嗰段,左邊擰一擰頭,緊接住又擰一擰頭,然後就去下一個 畫面 動作,成日覺得呢啲動作都未做完 就已經結束,成日覺得少咗啲乜嘢。
然後人臉方面,仔細睇前後有啲唔一致,而且皮膚質感仲係有啲AI。
2.0 fast嘅話 , 整體完整度好高,揾唔出特別毛病,由公寓、街道、水果檔到海邊,人物嘅樣、氣質同成條片嘅手持記錄感都冇明顯斷開,尤其呢個笑容都幾甜。
然後就係 片段中間有個水果檔嘅空鏡, 啱啱好令旅行路線更加似真實生活,唔係全部鏡頭都係人物行嚟行去,咁對vlog嚟講就有啲太呆,ps最後12秒嘅海邊日落都幾靚。
Wan 3.0整體畫面冇乜問題,但係呢個配樂有啲似兩段音樂溝埋一齊,感覺有啲亂七八糟。 咁要唔抽卡嚟解決呢個問題,最直接就係用剪接軟件分離音頻再換咗佢,雖然話唔算特別麻煩,但工作流程入面確實多咗一個步驟。
講道理,之前我都做過嗰個百cases橫測(之前我哋叫百鏡系列),或者可以話係各種各樣模型嘅橫向對比。
但每一次我覺得可惜嘅係,呢啲提示詞共通嘅優秀方法或者結構,又或者係描述畫面嘅方式,都冇存低。咁就導致而家一啲生成畫面,我可能會為咗某幾個字反覆打磨半個鐘,甚至更長時間。
所以GoodCase入面有一個我好鍾意嘅步驟,
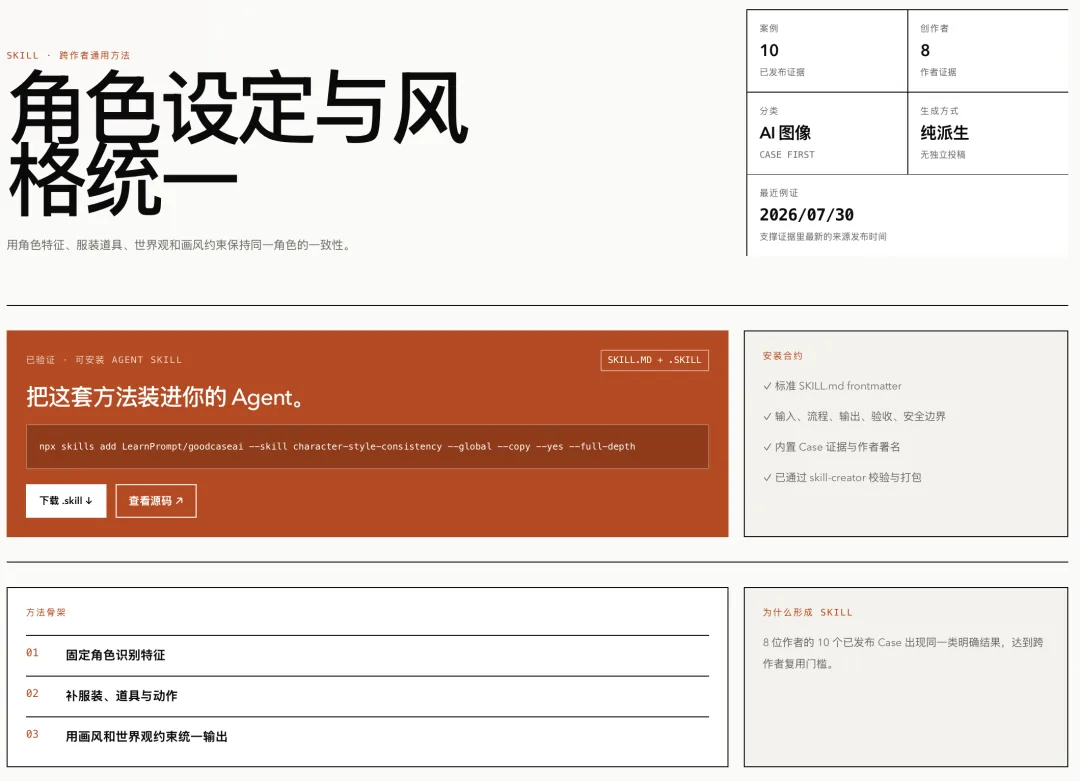
就係當同一種case或者同一個作者嘅同一個case做得比較多嘅時候,目前會先做一個硬性設定,只要超過5個,我就會嘗試將佢變成一個skill。後面我一定會持續迭代呢套算法。
好似呢個角色設定skill入面就參考咗8個作者嘅10個案例,可以直接加載到CodeX入面,等Image2根據呢個skill生成對應角色,好似呢個角色就係我用呢個skill生成出嚟。
06|寫喺最後 三組跑完,我覺得喺綜合性能上, d Seedance 2.0 fast嘅綜合能力更加均衡,每個場景都冇出大問題,確實會係我跑各種case嘅第一選擇。
我呢度講嘅均衡,係指佢喺八個完全唔同嘅case入面,幾乎冇一項出現呢個模型根本唔適合做嘅大問題。
多素材K-POP MV入面,佢嘅人臉、卡點同動作設計最平衡。多人打鬥入面,佢嘅力量感、環境反應同動作連貫都喺度。時間倒流嗰條,佢用15秒保住咗最難嘅因果鏈,效果已經可以接近我之前喺2.5上面跑嘅版本。餅乾同飲品廣告入面,佢會組織產品同賣點。二維PV佢唔及H3驚豔,但守住咗風格限制。Vlog同人臉特寫入面,佢唔一定每一幀都攞第一,但完整度同情緒指令執行冇甩底。
呢啲先係我睇重嘅嘢。
一個模型偶爾可以生成一條最勁嘅影片,同佢適唔適合做量產工作流程嘅第一個節點,係兩個問題。
工作室每日要跑嘅唔會淨係二維PV,都唔會淨係人臉特寫。今日係廣告,聽日係MV,下晝客戶又改咗個產品包裝。呢啲時候,模型可以唔可以畀你直接開工,比起佢某個上限demo有幾勁更加重要。
所以我會將Seedance 2.0 fast當做默認選項。fast速度快,成本低,綜合能力唔會出錯,好啱批量產出。我哋可以先用佢跑出可交付嘅版本,再睇嚇係咪需要進一步優化。
然後H3嘅話,我會更加推薦好似之前我哋講過,喺創意類型影片或者同二維動畫結合嘅方向去用,效果真係唔錯,仲建議優先喺768P低清晰度下先睇嚇提示詞效果,冇問題之後再跑去2K。
Wan 3.0嘅綜合能力其實都唔錯,而且而家可以直接出30秒嘅影片,但問題就係最近模型通道比較擠擁,成日排唔到隊,我都係凌晨先跑。
最後,呢度仲有一個特別容易俾人忽略嘅嘢,就係抽卡率。
做量產嘅人聽到呢三個字應該特別有感觸。API價格只係紙上嘅數字,真正決定成本嘅係,你平均要生成幾次先出一條用到。如果一個模型單價0.5元一秒,但平均要抽5次先出一條合格,2.0 fast ast 喺呢8個case入面,平均抽卡次數四捨五入係2次,後面我都會統計200條cases嘅平均抽卡次數。
OK,返去最開頭嗰個問題。
嗰啲喺社交媒體上好受歡迎嘅案例,提示詞到底係真定假?
跑完呢十萬積分嘅測試,我而家可以講一句,
大部分係真。
但喺唔同模型上面嘅表現差距真係好大,真唔代表可以直接攞嚟用。
呢個就係點解我要做GoodCase嘅原因。
就係為咗話畀所有人知,呢個案例喺邊個模型上係真,喺咩參數設置之下可以重現,換到另一個模型上面,你又需要點樣調整。
我一直覺得,揀模型呢件事冇標準答案,只有適合自己場景嘅最優解。但係揾到最優解呢件事本身,係需要有人去燒積分、去跑測試、去將數據攤開嚟睇。
三年喇。
由一個飛書文檔,去到一個經過驗證嘅實戰案例庫。
由存案例,到驗證案例,再到將案例抽象成Skill。
呢件事我覺得值得一直做落去。
好嘅案例、好嘅提示詞、好嘅方法論,如果唔去驗證、唔去整理、唔去跨模型交叉測試,佢哋就只係我哋資訊流入面一閃而過嘅碎片。
我想將呢啲碎片,
變成可以留低嘅嘢。
最後嘅最後,
呢篇文章入面所有嘅提示詞同比對影片,
我都整理好曬,
喺goodcase就睇到。
@ 作者 / 卡爾 & 阿湯
最後,多謝你睇到呢度👏 如果鍾意呢篇文章,不妨順手畀我哋 點讚|在看|轉發|留言 📣
如果想第一時間收到推送,不妨畀我個星標🌟
如果你有更加好玩嘅玩法,歡迎喺留言區傾嚇🤝
更多內容亦都喺度不斷填坑中……
這 兩週,視頻模型更新得太瘋了。 Seedance 2.5,MiniMax H3,Wan 3.0, F lux3, M eta M use V ideo ㅤ 和 G rok I magine V ideo, 我光是看各種demo就能看到凌晨一兩點。每個case都想上手跑一遍總結出提示語方法後再發出來,奈何就算我日更圖文和視頻都發不完這些GoodCase 。所以我開源了一個AI提示語案例網站,叫 goodcase.ai 。
ㅤ
01|我開源了維護3年的案例庫 平時做不完case我都會存到一個飛書知識庫,三年了,裏面存了上千條AI視頻、AI前端、Agent等等生成記錄。每一條都帶着完整的提示語,帶着我當時測試的模型版本,帶着當時生成出來的效果。
三年。
這個文檔,最早的一條記錄是2023年寫的。那時候Runway Gen-2剛出來,我還在為一個4秒的視頻開香檳。到今天,Seedance 2.5已經能直出30秒的畫面了。
當時提示語還很短,像這個視頻就一句, 風吹動女孩的頭髮,女孩悲傷地看着前方。
最近這個文檔有一個讓我越來越焦慮的問題,
每次模型一更新,前面攢的案例就開始大面積失效。不止是AI視頻,前陣子流行用Agent測UI生成,過幾週轉到3D遊戲了,再過幾周現在又繼續卷UI。燒積分測出來的一套方法論,也可以說是Skill,可能半個月就廢了。
我就一直在想一個問題,
這些在X上動不動就幾十萬播放的案例,那些提示語,到底是真的還是假的?
如果是真的,為什麼我用同樣的提示語,換一個模型跑出來的差距那麼大?如果是假的,那我們每天刷到的那些Amazing的效果,中間到底經過了多少人工干預,多少剪輯,多少挑幀?
這個問題困擾了我很久。久到我決定不再只是存案例了,我要做一件更較真的事。所以我做了一個網站, GoodCase.ai 。
我不想做那種追着模型更新吃一波流量的案例合集站,我見過太多這種了,風口來了堆一波內容,風口過了就沒人維護了。我想做的 就是建一個經過驗證,持續迭代,把優秀作者的方法論都總結下來的案例庫。
我驗證提示語真偽的方法也很樸素,
先把沒有提示語的案例全部踢掉,因為你不知道中間摻了多少水。然後拿同一批提示語,在不同模型上跑交叉驗證,看看到底是提示語厲害還是隻是某個特定模型能力上去了。最後,把那些真正跨模型都能跑通的多個案例,抽象成一個一個的Skill,方便以後不管模型怎麼迭代,都能直接調用。
這套方法聽起來有點折騰,但我自己就是這麼過來的。當初做AI視頻做到第一個100萬播放量,就是一輪一輪燒積分測出來的。
ㅤ
02|一次性跑幾百個AI視頻,怎麼選性價比最高的 我意識到,這兩週狂上新模型是一個絕佳的測試窗口。手裏有三年攢的提示語庫,眼前有剛發佈的新模型,那就乾脆做一次系統性的橫測,把goodcase.ai第一版做起來,用這兩週發的模型,跑一波經得起考驗的提示詞案例,也順便挑選表現最穩定的模型,畢竟跑AI視頻絕對是要儘可能減少積分的消耗。
十萬積分,就這麼燒出去了。
從首輪136個case裏,從720P檔位裏選了三個價格最接近的模型,Seedance 2.0 Fast、MiniMax H3、Wan 3.0,API價格分別是0.6元/秒、0.5元/秒、0.6元/秒,選出來表現最穩定且綜合成本 最划算 的一個。
所以接下來就是我們一起kukuku拿最近攢的提示語庫,逐場景把這三個模型挨個過了一遍。我選了三類提示語來測 ,覆蓋了視頻生成裏最有區分度的三種輸入方式。
ㅤ
03|多素材參考生視頻 超級多人來問我要這個Kpop MV的超長提示語,現在也完整上線了。
那我對多素材的定義是除了圖片還會有音頻、視頻的元素。這種場景對模型來說就是,它得理解你給的圖風格,還有音頻的節奏,如果想要畫面卡上點的話,在提示語階段就要寫比較長的提示語,所以對模型的長指令遵循能力也是有要求的。
那如果大家想做出來的MV有一種精準卡點的感覺,我建議可以用AI音樂工具生成固定時間段,再把它作為參考來生成視頻,這樣效果會比截取一段音頻更好。
每個模型都是生成15s,720p的清晰度,提示語用的是一樣的,這也是Goodcase現在內置的流程,通過API調用不同模型,這樣也不會受到Agent本身內置的提示語和skill影響。
為了讓大家有更沉浸的觀看效果,我把三個視頻拼在一起了。每個視頻 都 是 15 秒,從上到下分別是Minimax H3,Seedance 2.0 fast,Wan 3.0。
首先是H3,剛跑出來時乍一看感覺還挺不錯的,風格、動作節奏、卡點、場景都沒有任何問題,但中遠景鏡頭出現了人臉變形 和五官模糊的感覺。
接着 是Seedance 2.0 fast,它人臉是最清晰的,這讓整體觀感會更舒服,每一個節拍的卡點基本上都對的上,從開頭的手部舞蹈動作到最後的掛電話,動作設計是最符合kpop的感覺的。開頭還有魚眼視角和後面的光效轉場,這些細節都會讓整個成片看起來更加有層次。
最後Wan 3.0 ,整體也是不錯的,相比H3人臉會更穩定 。 舞蹈動作除了開頭的幾個鼓點沒有對應的舞蹈動作外,其餘的舞蹈動作卡點都能對的上。
ㅤ
04|文生視頻 我選的場景是多人打鬥、時間倒退和 餅乾廣告 。
這個場景我選得比較刻意,就是想把模型逼到極限。打鬥考驗的是動態生成能力,畫面裏多個人在打,動作要連貫,力量感要真實。時間倒退更狠,假髮要從半空回到男人的頭上,這種逆向物理邏輯對模型來說幾乎是地獄級的考試。餅乾廣告就是考審美的,以及模型如何表達水果餡餅乾和水果的關係。
而且這組是沒有任何圖片參考的,純靠文字描述來驅動畫面,做廣告的時候靠的就是模型自己的審美。先上打鬥,
電影感十足的韓國動作場面:一條狹窄而陽光明亮的城市巷弄,兩側是磚砌建築、空調外機和堆疊的木托盤,一家醒目的 GS25 便利店坐落其中。
一名身材矯健的年輕女子留着金色長髮,紮成高馬尾。她身穿修身的粉色長袖運動短上衣,下身搭配同色緊身運動褲和乾淨利落的粉色運動鞋。她的臉龐、頸部和上胸泛着一層細密汗光,顯然剛剛結束訓練,但神情依舊沉着、專注而堅定。
她與一羣身穿黑色運動服和連帽衫、來勢洶洶的年輕男子正面對峙。沒有絲毫遲疑,她猛然衝上前,以精準而強勁的格鬥技巧展開反擊:快如閃電的拳擊、迴旋踢、肘擊、膝撞、掃腿,以及乾淨利落的摔投接連使出。她憑藉流暢而寫實的動作編排,將襲擊者逐個擊倒。
手持攝影機緊貼人物穿行於狹窄巷道之中,通過富有動感的運鏡、輕微的鏡頭晃動、真實的運動模糊和快速切換的視角,強化每一次撞擊的力量與緊張感。隨着衝突不斷升級,眾人接連重重摔在路面上,整場打鬥在極具電影感的節奏中持續推進。
背景裏,三名身穿整潔校服的韓國女學生站在 GS25 門口附近,震驚得一言不發,目不轉睛地注視着眼前的衝突。明亮的自然日光在磚牆和堆疊的木托盤上投下清晰利落的陰影,也照亮了空氣中的塵埃、地面的碎屑以及周圍真實細膩的環境細節。
最終,最後一名襲擊者倒在堆疊的木托盤旁。女子停下腳步,從容地重新調整格鬥架勢,整理了一下粉色運動短上衣,隨後自信地沿着陽光照耀的巷道離去。
超寫實真人實拍風格,韓國動作電影美學,高強度動作編排,清晰細膩的面部細節,符合真實物理規律的人體運動,電影級手持攝影,自然光效,逼真材質與院線電影級畫面品質。
H3在快節奏動作的時候明顯整個人是有變糊的 情況 , 然後整體的打鬥感是有的,但是感覺有種對手都站在原地等着被打的感覺。
2.0 fast的打鬥感真的很強 ,從人物出場的對峙,到被打人物撞到 空調 激起灰塵來 體現打擊感, 中間還穿插了 路人的反應, 結尾背對人物一個飛踢的動作也很帥, 整理衣服的過程也非常乾淨利索。 這裏它最值得誇的是知道一場打鬥不是兩個人在畫面中間亂揮手。拳腳碰到人,環境要有反應,周圍的人也得知道這裏正在打架。灰塵、路人、不同景別和最後整理衣服的收尾都在服務同一段表演,不是單純靠快切來假裝有力量,對手的反應和女主的動作也接得更順。
Wan 3.0 主要是 有點物理bug,人物是穿牆出來的, 不過 不同景別切換很快能體現出打鬥 感和力量感。
但是最後的鏡頭人居然全部消失了。
OKOK,接着就是經典的時間倒退了,這個比上個case的差距就更加明顯了,而這裏我是把一個30s的提示語 壓縮成了15s 塞給三個模型去跑,看看大家的表現怎麼樣吧。
寫實電影感,白天遊樂園過山車。強烈陽光與疾風,軌道和背景呈現真實運動模糊,輕微手持感,細膩膚質,天然膠片顆粒。
0-4秒|中景:過山車高速俯衝轉彎。前排坐着一名二十歲出頭、神情淡定又略顯無聊的年輕女子,長髮迎風飛舞;身旁是一名戴着逼真假髮的中年男人,後排坐着另一名女子。
4-7秒|動態跟拍:強風猛地掀飛男人的假髮,露出光頭。假髮旋轉着向後飛去,凌亂地罩在後排女子臉上。眾人震驚尖叫的瞬間,時間驟然靜止,只有前排女子還能活動。
7-11秒|緩慢環繞:鏡頭掠過凝固在空中的髮絲、張大嘴的光頭男人,以及被假髮矇住臉的後排女子。年輕女子翻了個白眼,無聲嘟囔:“靠,又來。”她掏出一片口香糖,拆開、放入口中咀嚼。隨後整個世界精準倒放:假髮從後排女子臉上飛回,退至剛要脱離男人頭頂的瞬間,再次定格。
11-13秒|近景:年輕女子取出口香糖,按在男人頭頂中央,再把正在翹起的假髮用力壓回原位、撫平粘牢。她若無其事地坐好,嘴角浮現一絲隱秘笑意。
13-15秒|中景:時間恢復正常,過山車繼續俯衝。男人摸到假髮仍牢牢在位,先是困惑,隨即如釋重負地笑了。年輕女子目視前方,已經嚼起一片新的口香糖,神情平靜而滿足。
照片級真實,電影級時間連續性,人物外觀穩定;精準的風力、頭髮與假髮物理效果;運動模糊僅作用於移動物體;自然電影光影與濃郁膠片顆粒,無畸變、無穿幫,節奏緊湊,具有高重看價值。
H3最明顯的就是車沒停,雖然是慢速了。然後就是假髮飛回來的過程有點奇怪,也 許是因為飛回來的軌跡沒有按照原軌跡倒回的原因, 但是還可以接受。
不得不說,雖然我在同一個提示語在 2.5 上也跑過,但是2.0 Fast的表現還是蠻吸引我的。
首先就是,它會通過已經是時間停止的畫面,再通過鏡頭的轉換,體現出假髮倒回和把嚼過的口香糖貼回去這件事情是同時發生的。整體給我的感覺是,雖然說它做了慢鏡頭,但我能感覺到它是在一瞬間完成這個時間倒退動作的,和我之前用seedance2.5做的能有80%的相似度了。
最後就是 W an3.0這回有了大硬傷,沒有把車完全停下來,15秒內也沒有把假髮復原回來。
再就是,經典TVC了,
明亮繽紛的商業廣告風格,以水果夾心餅乾為絕對主角,呈現草莓、蘋果、葡萄和橙子四種口味。
餅乾與對應水果組成秩序感強烈的幾何陣列,畫面乾淨高級,富有鮮明節奏。開場由水果快速聚焦視線,音樂重拍同步切入;隨後,不同口味的餅乾整齊列隊,並迅速切換至產品特寫。
高潮部分,一塊餅乾被瞬間掰開,畫面隨即進入慢動作:水果夾心迸裂流出,餅乾碎屑四散飛濺,充分放大餡料的多汁質感與酥脆顆粒的衝擊力。隨後,多塊餅乾橫向排列,以富有節奏的拋物線軌跡騰空翻飛,突出產品整齊有序的視覺美感與豐富多樣的口味。
緊接着,剪輯重新加速。結尾處,英文文案“One bite of crispness, a heart full of delight”伴隨強烈節拍逐詞快速出現,文字動效與產品定格畫面精準配合。最終以具有品牌感的畫面收尾:餅乾與水果由中心向四周放射展開,營造年輕、活力、美味又讓人忍不住分享的廣告氛圍。
那首先,我覺得H3做了一個水果和餅乾長龍的拼接效果,是挺好看的 。 水果掉落飛濺的水珠、餅乾炸開的碎屑、水果餡拉絲、 水果餅乾排隊, 最後是畫面結尾的廣告語,動態畫面設計能力 確實不錯 。
Seedance 2.0 fast 整體的完成度也很不錯,整個片子是可以拿來用的程度,拉絲的果醬看起來最真實,結尾還採用了懸浮的效果來製作餅乾跟水果之間的切換, 尤其是那個餅乾反轉變換成水果的效果,酷酷酷 。如果我要把四種口味批量做成一套視頻,2.0 fast這種比較穩定的產品主體和快速迭代依然會是我的第一選擇。
再一個Wan 3 .0, 我就很喜歡 它 做這個餅乾,看起來就比一般的水果餅乾要好吃不少,而且他拋餅乾跟水果拋上去,再落下來的物理曲線都給人感覺挺真實的, ㅤ 就是中間掰開餅乾,果醬有點果汁感,橫截面也有點不一致了。
ㅤ
05|圖生視頻 這part我選了一個第一人稱vlog。
這個場景在量產裏出現的頻率太高了。做電商的需要人物vlog視角的產品展示,而人臉,是所有視頻生成模型最容易崩的地方。眼睛歪了,嘴角抽了,膚質變塑料了,這些問題在15秒的視頻裏只要出現一幀,整條就廢了。
我用的好朋友 @ BubbleBrain 的提示語,在x上20萬播放被goodcase每日腳本收錄進去了。
因為我沒有原來的提示詞裏的參考角色。所以我從視頻裏截取了兩幀,一幀能看清臉部細節,另一幀能看到完整的體態。然後,還是用GoodCase收藏的角色身份固定參考圖表+GPT Image2,生成了一張參考圖,好讓後面的模型能用這張圖來生成視頻。
生成出來的角色圖長這樣,表情矩陣、三視圖、不同角度的頭部,以及五官細節和色卡都出來了。
順便提一下,在收錄case的同時,goodcase還會分析目前這個提示語跟庫裏面其他提示語的不同點,以及怎麼樣把它改為我們自己的題材。還有就是用其他模型去運行這個提示語的時候,哪一個步驟是容易翻車的?
這樣一來會構成最終的兩個判斷,
1. 把它跑成一個合理的成片,成本是中高低? 2. 穩定度又是百分之多少? 所以來吧,看看三個模型在第一人稱vlog上的表現,
一段寫實的 15 秒手持旅行 Vlog,由朋友跟隨主角拍攝。使用參考圖片中的女性作為主角。在整個視頻中,始終保持她的面部身份、髮型、五官特徵和身材比例完全一致。畫面呈現真實的智能手機或微單相機質感,採用自然的手持運鏡、隨意的構圖、輕微的人為抖動,以及沒有表演痕跡的自然行為。0-3 秒:清晨出發。她揹着一個小揹包離開温馨的公寓,查看手機,對鏡頭微笑,整理頭髮,然後走進陽光明亮的社區街道。鏡頭從她身後近距離跟拍。3-7 秒:探索城市。她穿過熱鬧的本地街道,在一家小咖啡館買了一杯飲品,短暫看向鏡頭,並自然地笑起來。畫面快速、連貫地帶過街邊市場和小商店。7-12 秒:抵達海邊。她來到一座海濱小鎮,看見大海。海風吹動她的頭髮,她興奮地走向海邊,撿起一枚貝殼,然後回頭對鏡頭露出真誠的微笑。12-15 秒:黃金時刻收尾。她手裏拿着飲品,坐在海邊觀看日落。鏡頭緩慢向後移動,逐漸展現沙灘、海浪和温暖的傍晚光線,營造一段寧靜、私人的旅行回憶。視覺風格:真實自然的日常旅行 Vlog,具有紀錄片式寫實感、自然光線、即興的人物反應和連貫合理的鏡頭切換,同時始終保持人物身份一致。不要商業廣告式的電影感,不要刻意表演,不要誇張擺拍,不要生硬或人工化的轉場,不要文字疊加,不要 Logo,不要改變面部,也不要改變人物身份。這可能就是15秒的時間有點太趕了。H3特別是在拿奶茶那一段,左回一下頭,緊接着又回一下頭,然後就下一個 畫面 了,總感覺這些動作都沒有做完 就已經結束,就老感覺少了些啥。
然後就是人臉方面,仔細看前後有些不一致,而且皮膚質感還是有些AI。
2.0 fast的話 , 整體完整度很高,挑不出特別的毛病,從公寓、街道、水果攤到海邊,人物的臉、氣質和整條片子的手持紀錄感都沒有明顯斷掉,尤其這個笑容還挺甜的。
然後就是 片段中間有個水果攤的空鏡, 恰好讓旅行路線更像真實生活,不是全部鏡頭都是人物走動,那對於vlog來說就有點太呆了,ps最後12秒的海邊日落也是挺漂亮的。
Wan 3.0整體的畫面是沒什麼問題,但是這個配樂有點像兩段音樂摻在一起的感覺有點亂七八糟的 ,那要想不抽卡來解決這個問題,最直接的就是剪輯軟件分離音頻替換掉了,雖說不算特別麻煩,但工作流裏也確實是多了一個步驟。
講道理,之前我還做過那個百cases橫測(之前我們叫百鏡系列),或者說是各種各樣模型的橫向對比。
但每一次我比較可惜的是,這些提示語共通的優秀方法或者說結構或者說描述畫面的方式都沒有存下來。這就導致了現在有一些生成的畫面,我可能會因為某幾個字反覆打磨半小時、甚至更長時間。
所以GoodCase裏有我非常喜歡的一個步驟,
就是當同一種case或者同一個作者的同一個case做得比較多的時候,目前會先做一個硬性設定,只要超過5 個,我就會嘗試把它做成一個skill。後面我肯定會持續迭代這一套算法。
像是這個角色設定skill裏面就參考了8個作者的10個案例,能直接加載到CodeX裏面,讓Image2根據這個skill去生成對應的角色,就像這個角色就是我用這個skill生成的。
06|寫在最後 三組跑完了,我覺得在綜合性能上,See d ance 2.0 fast的綜合能力更均衡,每個場景都沒出大問題,確實會是我跑各種case的第一選擇。
我這裏的均衡,指的是它在八個完全不同的case裏,幾乎沒有一項出現這個模型根本不適合做的大問題。
多素材K-POP MV裏,它的人臉、卡點和動作設計最平衡。多人打鬥裏,它的力量感、環境反應和動作連貫都在。時間倒退那條,它用15秒保住了最難的因果鏈,效果已經能接近我之前在2.5上跑的版本。餅乾和飲料廣告裏,它會組織產品和賣點。二維PV它不如H3驚豔,卻守住了風格限制。Vlog和人臉特寫裏,它不一定每一幀都拿第一,但完整度和情緒指令執行沒掉隊。
這才是我看重的東西。
一個模型偶爾能生成一條最炸的視頻,和它適不適合成為量產工作流的第一個節點,是兩個問題。
工作室每天要跑的不會只是二維PV,也不會只是人臉特寫。今天是廣告,明天是MV,下午客戶又改了個產品包裝。這種時候,模型能不能讓你直接開工,比它的某個上限demo有多炸更重要。
所以我會把Seedance 2.0 fast當成默認選項。fast速度快,成本低,綜合能力不出錯,很適合批量產出。我們可以先用它跑出可交付的版本再去看看是不是需要進一步優化。
然後H3的話我會更推薦像之前我們說過的,在創意類型視頻或者在和二維動畫結合的方向去使用,效果是真的不錯,也建議優先使用768P低清晰度下先看看提示語效果,沒問題了之後再去跑2K。
Wan 3.0的綜合能力其實也不錯,而且現在能直出30秒的視頻,但問題就是最近模型通道比較擁擠,經常排不上號,我都是凌晨跑的。
最後,這裏還有一個特別容易被忽略的東西,就是抽卡率。
做量產的人聽到這三個字應該特別有感觸。API價格只是紙面上的數字,真正決定成本的是,你平均要生成幾次才能出一條能用的。如果一個模型單價0.5元一秒,但平均要抽5次才能出一條合格的,2.0 f ast 在這8個case裏面平均抽卡次數四捨五入是2次,後面我也會統計在200條cases的平均抽卡次數。
OK,回到最開始那個問題。
那些在社交媒體上大受歡迎的案例,提示語到底是真的還是假的?
跑完這十萬積分的測試,我現在就可以說一句,
大部分是真的。
但在不同模型上的表現差距真的很大,真的不代表能直接拿來用。
這也是我為什麼要做GoodCase的原因。
就是為了告訴所有人,這個案例上在哪個模型上是真的,在什麼參數設置下能復現,換到另一個模型上,你又需要怎麼調整。
我一直覺得,選模型這件事沒有標準答案,只有適合自己場景的最優解。但找到最優解這件事本身,是需要有人去燒積分、去跑測試、去把數據攤開來看的。
三年了。
從一個飛書文檔,到一個經過驗證的實戰案例庫。
從存案例,到驗證案例,到把案例抽象成Skill。
這件事我覺得值得一直做下去。
好的案例,好的提示語,好的方法論,如果不去驗證、不去整理、不去跨模型交叉測試,它們就只是我們信息流裏一閃而過的碎片。
我想把這些碎片,
變成能留下來的東西。
最後的最後,
這篇文章裏所有的提示語和對比視頻,
我都整理好了,
在goodcase就能看到。
@ 作者 / 卡爾 & 阿湯
最後,感謝你看到這裏👏 如果喜歡這篇文章,不妨順手給我們 點贊|在看|轉發|評論 📣
如果想要第一時間收到推送,不妨給我個星標🌟
如果你有更有趣的玩法,歡迎在評論區聊聊🤝
更多的內容正在不斷填坑中……