降低AI短劇創作門檻,一個Skill把小說拆成角色設定集:人物畫像、卡通形象提示詞、音色提示詞、三視圖
整理版優先睇
將小說拆成可用的角色設定集:novel-characters Skill 降低 AI 短劇角色一致性門檻
呢篇文章介紹一個 GitHub 開源項目 shuohao-skills(作者爍皓 / @eternityspring),核心係一個叫 novel-characters 嘅 Skill,專門解決 AI 短劇創作入面「角色設定唔穩定」嘅痛點。作者嘅背景係做 AI 內容生產工具,呢個項目係佢針對小說改編成短劇時,第一步就要固定人物角色嘅需求而設計。直接叫大模型總結小說角色,成日會作嘢或者漏嘢,所以佢將流程拆做掃描、歸併、出卡,再加腳本級硬校驗,確保輸出可靠。整體結論係:呢個 Skill 可以將小說自動拆成完整嘅角色設定集,包括人物畫像、出圖 Prompt、音色 Prompt、三視圖等,直接餵畀下游嘅作圖、配音、影片生成工具,令角色一致性呢個最難搞嘅位變成可復現、可校驗嘅流程。
個 Skill 嘅產出好完整:有 cast.json 結構化數據、Markdown 報告同互動式 report.html;每個角色都有性別、年齡、外貌、動機、人物弧光、關係網等,仲附帶原文引文做證據。出圖 Prompt 係中英雙語,連 Negative Prompt 同風格標籤都有,可以對應 Midjourney、Stable Diffusion、GPT-Image;音色 Prompt 就有音高、語速、口音等,對應 Qwen3-TTS、ElevenLabs。仲可以生成角色設定圖,16:9 構圖,左邊半身像做面部基準,右邊全身三視圖,白底方便摳圖。報告語…
- 結論:novel-characters 能將小說自動轉成完整角色設定集,解決 AI 短劇角色一致性的核心難題。
- 方法:用重疊 14k 字符塊掃描、歸併角色、生成卡片,並附原文引文做證據。
- 差異:腳本級硬校驗(引文逐字、Prompt 禁人名、字段語言分工)令佢比直接叫 AI 總結可靠好多。
- 啟發:出圖、音色、三視圖所有提示詞都生成好,直接對應 Midjourney、TTS 等工具,大幅降低創作門檻。
- 可行動點:需要 Node.js ≥18 同 Claude Code/Codex,零額外 API Key,安裝後用 /novel-characters 便可跑。
shuohao-skills GitHub 倉庫
開源項目,包含 novel-characters Skill,用於將小說拆成角色設定集。
背景:AI 短劇嘅角色一致性難題
最近,MiniMax H3 等本地可跑嘅多模態模型陸續開放,AI 短劇嘅話題徹底炸開。技術確實在快速下沉,但真正上手做一部短劇嘅話,好快會撞到硬牆。
第一步就必須固定人物角色,外貌不一致、聲線漂移、關係混亂、動機前後矛盾,呢啲細節一飄,後面所有生成都會崩。
手動整理角色設定費時失事,直接叫大模型「總結一下」又容易作嘢、漏掉關鍵證據。
呢個時候,GitHub 上有個好對症嘅開源項目:shuohao-skills(作者:爍皓 / @eternityspring)。
核心 Skill 叫 novel-characters,佢會自動輸出完整嘅角色設定集。
一個 Skill 產出全套角色設定
將一本小說或者短故事掟入去,novel-characters 會做以下嘢:
- 角色表:識別所有出場人物,歸併跨章節唔同稱呼(例如「陸行遠 / 陸 / 姑娘」收斂做同一人),再按戲份權重排序。
- 人物畫像:性別、年齡、身份、外貌、性情、動機、人物弧光、關係網,每條都附帶原文逐字引文,防止模型作嘢。
- 形象提示詞:中英雙語出圖 Prompt + Negative Prompt + 風格標籤,可以直接餵畀 Midjourney、Stable Diffusion、GPT-Image 等。
- 音色提示詞:音色、音高、語速、口音、情緒描述,適合 Qwen3-TTS、ElevenLabs 等語音設計工具。
- 角色設定圖(可選):16:9 構圖,左邊半身像(面部基準)+ 右邊全身三視圖 + 細節特寫條。白底方便摳圖。支援半寫實厚塗或吉卜力動畫風。
最終產出包括 cast.json(結構化數據)、Markdown 報告,同一個雙擊就開到嘅交互式 report.html。
報告語言默認中文,亦支援英文、日文、法文、韓文等,出圖風格亦可切換。
cast.json 可以直接餵畀下游工具,係成個流程嘅關鍵接口。
點解佢比「直接叫 AI 總結」可靠?
作者將工作流拆成兩條,再加咗硬校驗,確保模型唔會亂嚟:
- 1 掃描階段:將長文本切做帶重疊嘅 14k 字符塊,併發提取角色名、別名、描寫同原文引文。
- 2 歸併 + 出卡:按名字與別名收斂角色,只對戲份最重嘅 N 位生成完整角色卡;同批角色互相知道對方個名,避免撞樣同撞聲。
- 3 腳本級校驗:唔靠模型自覺,強制規範輸出。
同批角色互相知道對方個名,避免撞樣同撞聲。
- 引文必須係原文逐字連續片段。
- 出圖 Prompt 禁止出現人名,因為圖像模型對人名偏見極重。
- 字段語言嚴格分工:人類可讀字段跟隨報告語言,出圖/TTS Prompt 永遠英文。
- 結構與枚舉值校驗,確保格式符合預期。
腳本級校驗係成個項目最紮實嘅部分,令輸出結果有實際保證。
點樣開始用?
前置條件極簡:
Node.js ≥ 18(腳本零依賴,唔使 npm install)
,已經裝咗 Claude Code 或 Codex。
git clone https://github.com/eternityspring/shuohao-skills.git
cd shuohao-skills
./scripts/install.sh
# 之後喺 Claude Code 或者 Codex 入面:
/novel-characters ./你嘅小說.txt
/novel-characters ./book.txt --lang en --style ghibli
之後就可以直接 `/novel-characters ./你嘅小說.txt`,或者用自然語言同佢講。
支援指定語言同風格,例如 --lang en --style ghibli。
零額外 API Key,直接走你而家 Claude Code 或 Codex 會話嘅額度。
項目倉庫有樣例《渡口》(民國渡口上嘅四個角色),專門驗證別名歸併等邊界情況。跑完就可以睇到完整報告同設定圖效果。
對 AI 短劇創作者嘅意義
喺 MiniMax H3 呢類模型令影片生成變平嘅時代,
一致性反而成為真正嘅門檻。
novel-characters 將「從文本到可用角色腳本」做成可復現、可校驗、可直接餵畀下游工具嘅流程。
係一個真正面向實際工作流嘅工程化 Skill。
目前倉庫已有一定關注度,採用
Apache 2.0 開源,Skill 設計自包含,方便單獨抄走或者二次開發。
如果你正用緊 Claude Code 或 Codex 做小說改編、短劇、動畫、有聲書等內容生產,可以去跑一遍自帶樣例睇嚇效果。
最近 MiniMax H3 呢啲本地行到嘅多模態模型陸續開放,AI短劇嘅話題真係爆曬。好多人都好興奮咁試緊,技術確實係快速普及緊。
但係真係落手做一部短劇嘅話,好快就會撞到硬牆:由小說轉去劇本、分鏡、出圖、配音,第一步就一定要將人物角色固定好。
外貌唔一致、聲線漂移、關係亂曬、動機前後矛盾……呢啲細節一有飄忽,之後所有生成都會冧。手動去整理角色設定又嘥時間又嘥心機,直接叫大模型「總結一下」又容易老作,仲會漏咗啲關鍵證據。
GitHub 上面有個好啱用嘅開源項目:shuohao-skills(作者:爍皓 / @eternityspring)。
佢解決咗啲咩問題?
核心嘅 Skill 叫 novel-characters。
將一本小說(或者短故事)掟入去,佢會自動輸出完整嘅角色設定集:
• 角色表:認出所有出場人物,將跨章節唔同嘅稱呼歸埋一齊(例如「陸行遠 / 陸 / 姑娘」收斂做同一個人),仲按戲份嘅輕重排好次序。 • 人物畫像:性別、年齡、身份、外貌、性情、動機、人物弧光、關係網——每一項都附帶原文逐字引文,防止個模型亂作。 • 形象提示詞:中英雙語出圖 Prompt + Negative Prompt + 風格標籤,可以直接餵畀 Midjourney、Stable Diffusion、GPT-Image 等等。 • 音色提示詞:音色、音高、語速、口音、情緒描述,啱 Qwen3-TTS、ElevenLabs 呢類語音設計工具用。 • 角色設定圖(可選):16:9 構圖,左邊半身像(面部基準)+ 右邊全身三視圖 + 細節特寫條。白底方便退地。支援半寫實厚塗或者吉卜力動畫風。
最終會出到:
• cast.json(結構化數據)• Markdown 報告 • 一個雙擊就開到嘅互動式 report.html
報告語言可以指定(預設中文,支援英文、日文,甚至法文、韓文等,介面文字會同步配合)。出圖風格都可以切換。
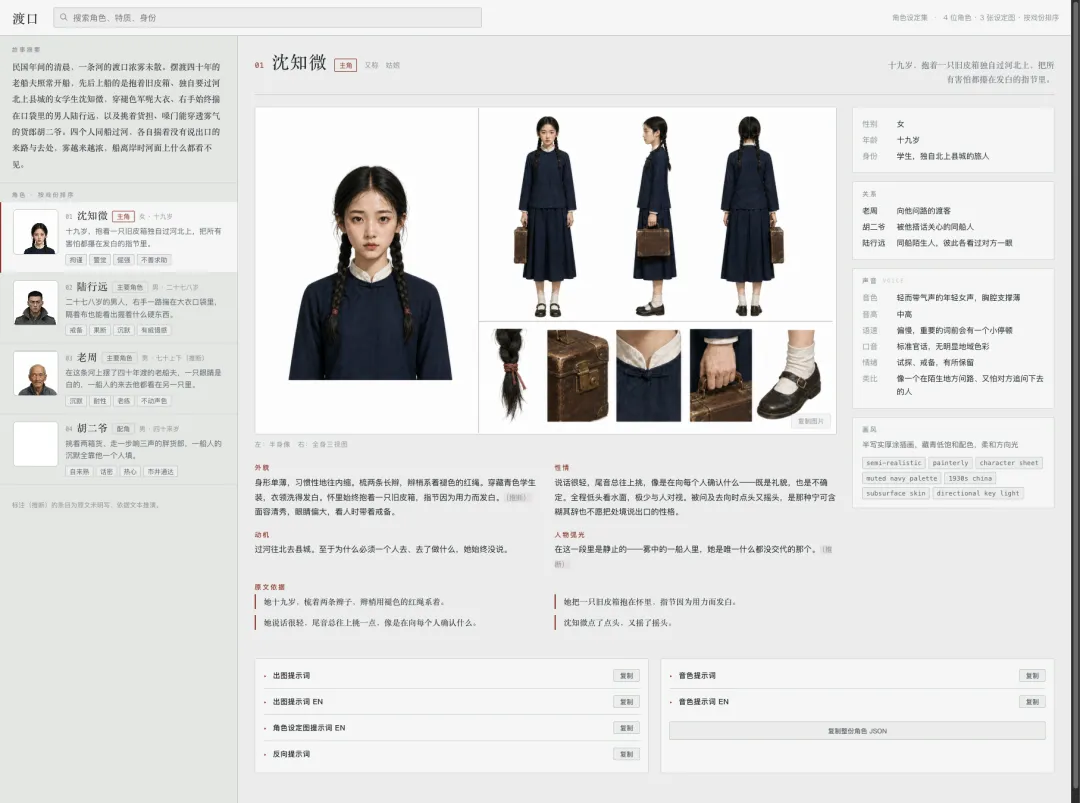
點解佢比「直接叫 AI 總結」可靠?
作者將工作流程拆做兩條,仲加咗硬性校驗:
1. 掃描階段:將長文本切成有重疊嘅 14k 字符區塊,並行提取角色名、別名、描寫同原文引文。 2. 歸併 + 出卡:按名同別名歸納角色,只會對戲份最重嘅 N 位生成完整角色卡。同一批角色互相知道對方個名,避免樣貌同聲線撞埋一齊。 3. 腳本級校驗(唔靠模型自覺): ◦ 引文一定要係原文逐字連續片段 ◦ 出圖 Prompt 唔準出現人名(圖像模型對人名好大偏見) ◦ 欄位語言嚴格分工(人類可讀嘅欄位跟報告語言,出圖/TTS Prompt 永遠用英文) ◦ 結構同枚舉值校驗
呢啲規則唔係求其定出嚟,而係項目根據模型真實踩過嘅坑,畀腳本捉到之後總結出嚟嘅。
成個過程零額外 API Key,直接用你而家 Claude Code 或者 Codex 會話嘅額度。有 Codex CLI 先會出圖,冇就淨係出提示詞,其他產出照常。
點樣用?
前置條件極之簡單:
• Node.js ≥ 18(腳本零依賴,唔使 npm install) • 已經裝咗 Claude Code 或者 Codex
安裝:
git clone https://github.com/eternityspring/shuohao-skills.git
cd shuohao-skills
./scripts/install.sh
之後直接:
/novel-characters ./你的小說.txt
或者用自然語言講「幫我拆嚇呢本書嘅角色」。
支援指定語言同風格:
/novel-characters ./book.txt --lang en --style ghibli
項目倉庫入面提供咗樣例《渡口》(民國渡口上嘅四個角色),專門驗證咗別名歸併呢啲邊界情況。行完就可以見到完整嘅報告頁面同設定圖效果。
對 AI 短劇創作者嚟講代表啲咩?
喺 MiniMax H3 呢類模型令到影片生成變平嘅時代,一致性反而變成真正嘅門檻。
novel-characters 將「由文本到可用角色腳本」呢件事,做成一個可以重現、可以校驗、可以直接餵畀下游工具嘅流程,係一個真正面向實際工作流程嘅工程化 Skill。
而家倉庫已經有一定關注度,用 Apache 2.0 開源,Skill 設計係自包含,方便單獨複製走或者二次開發。
如果你而家用緊 Claude Code 或者 Codex 做內容生產,特別係小說改編、短劇、動畫、有聲書呢啲方向,可以去行一次佢自帶嘅樣例睇嚇效果。
項目倉庫:
https://github.com/eternityspring/shuohao-skills
有用嘅話,轉畀而家搞緊 AI 短劇嘅朋友。
最近,MiniMax H3等本地可跑的多模態模型陸續開放,AI短劇的話題徹底炸了。很多人都在興奮地嘗試,技術確實在快速下沉。
但真正上手做一部短劇的話,很快會撞上硬牆:小說轉劇本、分鏡、出圖、配音,第一步就必須固定人物角色。
外貌不一致、聲線漂移、關係混亂、動機前後矛盾……這些細節一旦飄,後面所有生成都會崩。手動整理角色設定費時費力,直接讓大模型“總結一下”又容易編造、漏掉關鍵證據。
GitHub上有一個非常對症的開源項目:shuohao-skills(作者:爍皓 / @eternityspring)。
它解決什麼問題?
核心Skill叫 novel-characters。
把一本小說(或短故事)丟進去,它會自動輸出完整的角色設定集:
• 角色表:識別所有出場人物,歸併跨章節不同稱呼(比如“陸行遠 / 陸 / 姑娘”收斂為同一人),並按戲份權重排序。 • 人物畫像:性別、年齡、身份、外貌、性情、動機、人物弧光、關係網——每條都附帶原文逐字引文,防止模型瞎編。 • 形象提示詞:中英雙語出圖Prompt + Negative Prompt + 風格標籤,可直接餵給Midjourney、Stable Diffusion、GPT-Image等。 • 音色提示詞:音色、音高、語速、口音、情緒描述,適配Qwen3-TTS、ElevenLabs等語音設計工具。 • 角色設定圖(可選):16:9構圖,左側半身像(面部基準)+ 右側全身三視圖 + 細節特寫條。白底方便摳圖。支持半寫實厚塗或吉卜力動畫風。
最終產出:
• cast.json(結構化數據)• Markdown報告 • 一個雙擊就能打開的交互式 report.html
報告語言可指定(默認中文,支持英文、日語,甚至法語、韓語等,界面文案會同步適配)。出圖風格也可切換。
為什麼它比“直接讓AI總結”靠譜?
作者把工作流拆成兩條,並加了硬校驗:
1. 掃描階段:把長文本切成帶重疊的14k字符塊,併發提取角色名、別名、描寫和原文引文。 2. 歸併 + 出卡:按名字與別名收斂角色,只對戲份最重的N位生成完整角色卡。同批角色互相知道對方名字,避免長相和聲線撞車。 3. 腳本級校驗(不依賴模型自覺): ◦ 引文必須是原文逐字連續片段 ◦ 出圖Prompt禁止出現人名(圖像模型對人名偏見極重) ◦ 字段語言嚴格分工(人類可讀字段跟隨報告語言,出圖/TTS Prompt永遠英文) ◦ 結構與枚舉值校驗
這些規則不是拍腦袋,而是項目根據模型真實踩過的坑被腳本抓住後總結出來的。
整個過程零額外API Key,直接走你當前Claude Code或Codex會話的額度。有Codex CLI才出圖,沒有就只出提示詞,其他產出照常。
怎麼用?
前置條件極簡:
• Node.js ≥ 18(腳本零依賴,不需要npm install) • 已安裝Claude Code或Codex
安裝:
git clone https://github.com/eternityspring/shuohao-skills.git
cd shuohao-skills
./scripts/install.sh
之後直接:
/novel-characters ./你的小說.txt
或自然語言說“幫我拆一下這本書的角色”。
支持指定語言和風格:
/novel-characters ./book.txt --lang en --style ghibli
項目倉庫裏提供了樣例《渡口》(民國渡口上的四個角色),專門驗證了別名歸併等邊界情況。跑完就能看到完整的報告頁面和設定圖效果。
對AI短劇創作者意味着什麼?
在MiniMax H3這類模型讓視頻生成變便宜的時代,一致性反而成了真正的門檻。
novel-characters把“從文本到可用角色腳本”這件事,做成了可復現、可校驗、可直接餵給下游工具的流程,是一個真正面向實際工作流的工程化Skill。
目前倉庫已有一定關注度,採用Apache 2.0開源,Skill設計自包含,方便單獨拷走或二次開發。
如果你正在用Claude Code或Codex做內容生產,尤其是小說改編、短劇、動畫、有聲書方向,可以去跑一遍自帶樣例看看效果。
項目倉庫:
https://github.com/eternityspring/shuohao-skills
有用的話,轉給正在搞AI短劇的朋友。